번역 품질을 평가할 때 단순히 “좋다” 또는 “나쁘다”라고 판단하는 것만으로는 충분하지 않다. 특히 여러 언어와 벤더를 동시에 관리하는 로컬라이제이션 환경에서는 품질을 일관된 기준으로 분류하고 측정할 수 있는 방법이 필요하다. 이때 가장 대표적으로 사용되는 프레임워크 중 하나가 MQM(Multidimensional Quality Metrics)이다.
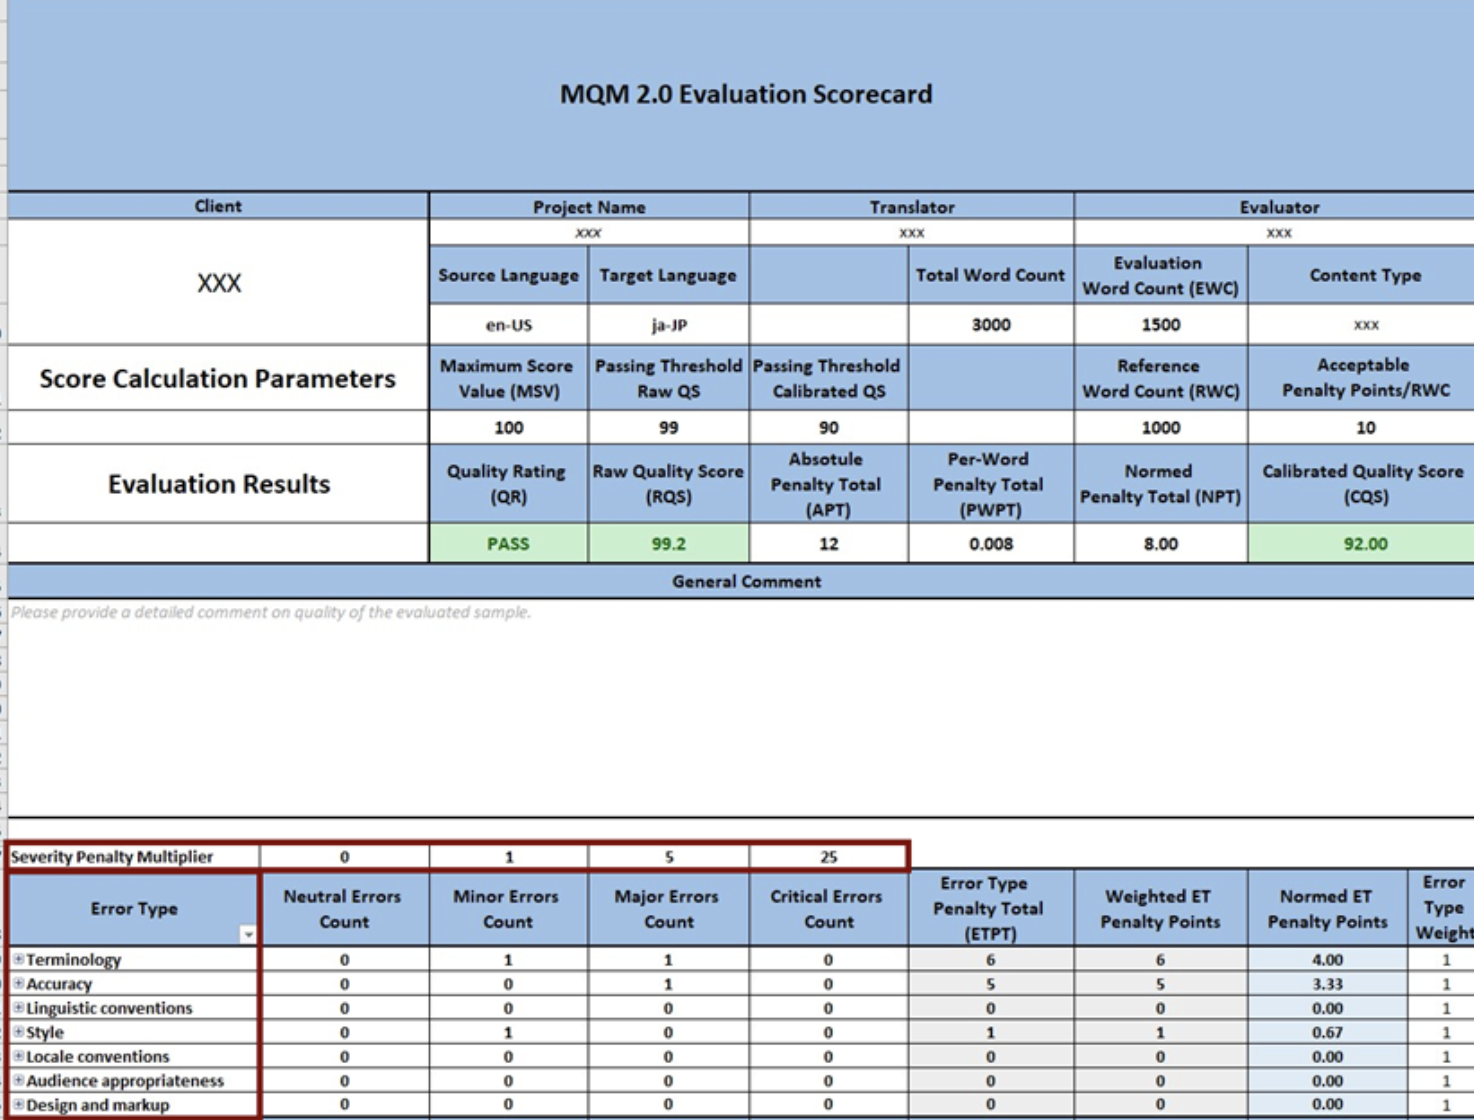
 

출처: MQM Council (https://www.themqm.org/mqm-pillars/the-mqm-scoring-models/)


MQM은 번역에서 발견되는 문제를 오류 유형(Error Type)오류 심각도(Severity)에 따라 분류하는 품질 평가 프레임워크다.


예를 들어 아래와 같은 번역이 있다면 문법적으로는 자연스럽지만 의미가 잘못 전달되었으므로 Accuracy → Mistranslation 오류로 분류할 수 있다.


Source: Delete account
Translation: 계정에서 로그아웃


반면, "계정을 삭제 할 수 있습니다."처럼 의미 전달에는 문제가 없지만 띄어쓰기가 잘못되었다면 Fluency 계열의 오류로 볼 수 있다. 즉, MQM은 모든 문제를 단순히 ‘오류 1건’으로 계산하는 것이 아니라 무엇이 잘못되었는지, 그리고 그 오류가 얼마나 중요한지를 구분한다.


MQM 대표 오류 유형

MQM은 계층적인 오류 분류법을 제공한다. 실제로는 프로젝트와 콘텐츠에 따라 필요한 항목을 선택하거나 세분화해서 사용할 수 있다.

유형 평가 대상 대표 세부 오류
Accuracy 원문의 의미가 정확하게 전달되었는가 Mistranslation, Omission, Addition
Terminology 적절하고 일관된 용어를 사용했는가 Wrong Term, Inconsistent Term
Fluency 번역문 자체가 언어적으로 올바른가 Grammar, Spelling, Punctuation
Style 요구되는 문체와 스타일을 따르는가 Register, Style Guide 위배
Locale Convention 해당 지역의 표기 관습을 따르는가 날짜, 시간, 숫자, 통화, 단위
Design & Markup 형식이나 구조에 문제가 없는가 Tag, Markup, Layout 문제


물론 모든 카테고리를 사용할 필요는 없다. 일반적인 소프트웨어 로컬라이제이션이라면 Accuracy, Terminology, Fluency, Style, Locale Convention 정도의 핵심 카테고리로 시작하고 필요에 따라 세분화하는 것도 흔하다.


오류의 심각도

같은 종류의 오류라도 사용자에게 미치는 영향은 다르다. 따라서 MQM에서는 오류 유형과 함께 심각도를 기록한다.

심각도 의미 예시
Minor 이해나 사용에 큰 영향을 주지 않는 오류 사소한 문법, 철자, 구두점 오류
Major 의미 전달이나 사용성에 상당한 영향을 주는 오류 중요한 오역, 잘못된 제품 용어
Critical 안전·법률·재정·데이터 등에 심각한 영향을 줄 수 있는 오류 안전 경고의 의미 반전, 법적 정보 오역


여기서 중요한 것은 오류의 양과 심각도가 반드시 비례하지 않는다는 점이다. 단어 하나가 잘못 번역되었더라도 사용자의 안전이나 데이터에 영향을 준다면 Critical 오류가 될 수 있다.


MQM 점수 계산

Severity에 가중치를 부여하면 번역 품질을 정량화할 수도 있다. 예를 들어 우리 팀에서 다음과 같이 가중치를 정했다고 가정해보자.


심각도 가중치
Minor 1
Major 5
Critical 25


1,000단어를 리뷰해서 Minor 3건, Major 2건이 발견되었다면 다음과 같이 페널티가 발생한다.

(3 × 1) + (2 × 5) = 13


이를 전체 단어 수로 정규화해 '1,000단어당 오류 점수'와 같은 내부 품질 지표를 만들 수도 있다. 다만 MQM이 특정한 가중치나 하나의 절대적인 Pass/Fail 점수를 강제하는 것은 아니다. 조직은 콘텐츠의 특성과 품질 목표에 맞게 점수 산정 모델과 Pass/Fail 기준을 설계할 수 있다.


MQM의 활용

MQM 데이터가 축적되면 단순한 번역 검수를 넘어 다양한 품질 분석이 가능하다.

언어별 품질 추적 한국어와 일본어의 분기별 Quality Score 비교
Vendor Performance 벤더별 Accuracy/Major 오류율 비교
Error Trend 분석 Terminology 오류가 지속적으로 증가하는지 확인
Root Cause Analysis 반복되는 오류가 번역, 용어집, 소스, 컨텍스트 중 어디에서 발생하는지 분석
MT/AI 평가 Human Translation, MT, LLM 번역의 오류 유형 비교


특히 MQM의 장점은 “품질이 낮다”에서 끝나지 않고 왜 품질이 낮은지를 데이터로 볼 수 있다는 것이다. Terminology 오류가 반복된다면 텀베이스를 개선할 수 있고, 여러 언어에서 동일한 Accuracy 오류가 발생한다면 번역가보다 원문 자체나 맥락 제공 방식에 문제가 있을 가능성도 살펴볼 수 있다.


MQM의 장점과 단점

장점 단점
품질을 구조적으로 측정할 수 있다 리뷰에 시간과 비용이 든다
오류의 원인을 구체적으로 분석할 수 있다 리뷰어마다 판단 기준이 달라질 수 있다
언어·벤더·기간별 비교가 가능하다 지나치게 복잡한 세부 분류법은 운영하기 어렵다
프로젝트에 맞게 커스텀할 수 있다 점수가 번역의 모든 측면을 설명하지는 못한다
MT/AI 번역 평가에도 활용할 수 있다 리뷰어 트레이닝과 정렬 작업이 필요하다


MQM 활용 시 고려 사항

MQM을 도입한다고 해서 번역 품질이 자동으로 객관화되는 것은 아니다. 예를 들어 동일한 오류를 한 리뷰어는 Major라고 판단하고 다른 리뷰어는 Minor라고 판단한다면 두 사람이 만든 MQM 점수를 그대로 비교하기 어렵다.


특히 여러 언어를 평가할 때는


한국어 Quality Score: 82

일본어 Quality Score: 95


라는 결과가 실제 품질 차이인지, 아니면 한국어 리뷰어가 일본어 리뷰어보다 엄격하기 때문인지 구분하기 어려울 수 있다. 따라서 MQM을 안정적으로 운영하려면 명확한 오류의 정의와 심각도 기준, 실제 예시, Reviewer Training, 그리고 정기적인 리뷰어 평가 기준 정렬 작업(Reviewer Calibration)이 함께 필요하다.


리소스

MQM을 실제 품질 평가에 적용해보고 싶거나 더 자세하게 알아보고 싶다면 MQM Council 웹사이트를 참고해보길 추천하다. 오류 유형과 심각도를 실제 점수로 변환하는 방법부터 가중치, Pass/Fail 기준을 설정하는 방법까지 자세히 설명되어 있으며, 바로 활용해볼 수 있는 Excel 기반 MQM Scorecard도 무료로 제공한다. 처음부터 자체 평가표를 만드는 것보다 이 자료를 바탕으로 조직이나 프로젝트에 필요한 Error Type과 평가 기준을 조정해 보는 것도 좋은 출발점이 될 수 있다.


“지난번과 같은 표현으로 번역해 주세요.”


클라이언트가 새로운 번역 프로젝트를 요청하며 이렇게 말한다. 지난번 프로젝트에 참여했던 번역가가 다시 배정되었고, 이전 번역도 번역 메모리에 모두 저장되어 있다. 겉으로 보기에는 같은 품질과 스타일을 유지하기 어렵지 않아 보인다.


하지만 작업을 시작하자 같은 기능이 세 가지 이름으로 나타난다. 어떤 문장에서는 ‘활동’, 다른 문장에서는 ‘액티비티’, 또 다른 곳에서는 ‘운동’이라고 번역되어 있다. 기존 번역은 ‘합니다’체와 ‘해요’체가 섞여 있고, 몇 달 전에 바뀐 제품명이 번역 메모리에는 여전히 이전 이름으로 남아 있다. LSP는 어느 표현을 따라야 할지  문의하고, 클라이언트의 로컬라이제이션팀은 제품팀과 지역 마케팅팀에 다시 확인한다. 확인하는 사람마다 기억하는 결정이 조금씩 다르다. 결국 출시를 앞두고 리뷰어가 상당수의 문장을 다시 수정한다.


실무에서 어렵지 않게 볼 수 있는 장면이다. 이 경우 문제는 번역가가 이전 번역을 보지 않았다는 데 있지 않다. 회사가 그동안 내린 언어적 결정을 한 곳에 정리하고 관리하지 못했다는 데 있다.


*


번역 프로젝트 후 남는 것들

번역 프로젝트가 끝나면 번역된 문장만 남는 것이 아니다. 제품의 핵심 기능을 무엇이라고 부르기로 했는지, 사용자에게 어떤 어조로 말하기로 했는지, 반복되는 문장을 이전에는 어떻게 번역했는지, 특정 표현을 사용하지 않기로 한 이유도 함께 남는다.


이렇게 번역 과정에서 축적된 언어적 지식과 결정을 언어 자산(linguistic assets)이라고 한다. 대표적인 언어 자산에는 스타일 가이드(Style Guide), 용어집(Glossary), 번역 메모리(Translation Memory), 그리고 부가적으로 참고 자료(Reference material)와 질의 기록(Query) 등이 있다. 흔히 이들을 번역을 도와주는 참고 파일 정도로 생각하지만, 잘 관리된 언어 자산은 그보다 훨씬 큰 역할을 한다. 새로운 번역가와 벤더가 제품의 언어를 빠르게 이해하도록 돕고, 여러 프로젝트와 언어에 걸쳐 일관성을 유지하며, 이미 내린 결정을 매번 처음부터 논의하는 일을 줄인다. 무엇보다 언어 자산은 한 회사가 사용자에게 어떻게 말해왔는지를 기억한다.


스타일 가이드

"Download the app"은 다음과 같이 여러 방식으로 번역할 수 있다.

앱을 다운로드하십시오.
앱을 다운로드하세요.
앱을 받아보세요.


세 문장 모두 의미는 맞다. 그러나 한 제품 안에서 어떤 화면은 “다운로드하십시오”, 다른 화면은 “다운로드하세요”라고 말한다면 사용자는 미묘한 불일치를 느낀다. 어느 표현이 맞는지는 사전이나 번역가 개인의 선호만으로 결정할 수 없다. 금융 서비스처럼 정확성과 신뢰감을 강조하는 제품과 가볍고 친근한 운동 앱은 사용자에게 말하는 방식이 다를 수 있기 때문이다.


스타일 가이드는 이런 선택의 기준을 정한다. 존댓말의 수준, 문장의 길이, 사용자 호칭, 능동태와 수동태, 숫자와 단위 표기, 문장부호, 외래어 표기처럼 반복적으로 필요한 원칙을 담는다. UI와 마케팅, 고객지원 콘텐츠에 서로 다른 어조가 필요하다면 그 차이도 설명한다.

좋은 스타일 가이드는 금지사항만 나열하지 않는다. 브랜드가 어떤 목소리를 지향하는지 설명하고, 권장하는 표현과 피해야 할 표현을 실제 예시로 보여준다.

지향하는 표현: 운동을 시작해 보세요.
피해야 할 표현: 운동을 시작하십시오.

이유: 전문성을 유지하되 사용자에게 명령하는 인상을 줄이지 않는다.


규칙보다 중요한 것은 그 규칙을 만든 의도다. 의도를 이해한 번역가는 가이드에 없는 새로운 문장을 만났을 때도 일관된 결정을 내릴 수 있다.


용어집

제품에는 일반 사전만으로 번역하기 어려운 단어가 많다. trip, journey, route, course 등의 단어들이 일상에서는 비슷하게 사용될 수 있지만, 하나의 내비게이션이나 운동 제품 안에서는 각각 다른 기능을 가리킬 수 있다. 이 단어들을 모두 ‘경로’라고 번역하면 사용자는 서로 다른 기능을 구분하기 어렵다. 반대로 문맥마다 자유롭게 번역하면 같은 기능의 이름이 화면에 따라 달라진다. 용어집은 이런 핵심 개념의 승인된 번역을 관리한다. 조금 더 체계적인 용어집에는 원문과 번역어뿐 아니라 다음과 같은 정보도 포함될 수 있다.

  • 용어의 정의와 품사
  • 승인된 번역과 사용하지 않는 번역
  • 실제 사용 예시
  • 관련 기능이나 제품
  • 대소문자와 복수형 규칙
  • 언어 또는 지역별 예외
  • 용어를 승인한 사람과 변경 이력

예를 들어 activity의 승인 번역이 ‘활동’이라고 적혀 있더라도 그것만으로는 충분하지 않을 수 있다. 운동 기록을 의미하는지, 사용자의 일반적인 앱 활동을 뜻하는지, 특정 제품 기능의 공식 명칭인지에 따라 다른 번역이 필요하기 때문이다. 좋은 용어집은 단어의 번역보다 개념의 경계를 설명한다. “이 단어를 이렇게 번역하라”뿐 아니라 “이 용어는 무엇이며, 언제 이 번역을 사용해야 하는가”에 답할 수 있어야 한다.


번역 메모리

번역 메모리(Translation Memory, TM)는 이전에 번역한 원문과 번역문을 문장 또는 세그먼트 단위로 저장한다.


새로운 원문이 들어오면 번역 툴은 번역 메모리에서 같거나 비슷한 문장을 찾아 번역가에게 제안한다. 완전히 같은 문장은 100% 매치로, 일부가 다른 문장은 퍼지 매치로 나타난다. 예를 들어 이전에 다음 문장을 번역했다고 해보자.

Connect your device to the app.
기기를 앱에 연결하세요.


새 프로젝트에 Connect your watch to the app이라는 문장이 들어오면 번역 메모리는 기존 번역을 비슷한 문장으로 제안한다. 번역가는 이를 참고해 빠르게 “시계를 앱에 연결하세요”라고 번역할 수 있다.


반복이 많은 소프트웨어와 기술 문서에서는 번역 메모리가 일정과 비용을 크게 줄여준다. 버튼, 오류 메시지, 설정 안내처럼 자주 반복되는 문구의 일관성을 유지하는 데도 유용하다. 하지만 번역 메모리는 정답을 기억하는 시스템이 아니다. 이전의 결정을 기억하는 시스템이다. 과거의 번역이 잘못되었거나 제품의 스타일이 바뀌었다면 번역 메모리는 오래된 결정도 충실하게 제안한다. 기능명이 변경되었는데 기존 번역이 정리되지 않았다면, 높은 매치율을 가진 오래된 제품명이 새로운 콘텐츠에 계속 들어갈 수 있다.


실제 실무에서 지켜보면 100% 또는 하이 퍼지(High-fuzzy) 매치라는 이유로 충분한 검토 없이 번역이 승인되는 경우가 허다하다. 이후 제품 화면에서 문제가 발견되면 사람들은 새로 작업한 번역가를 의심하지만, 실제 오류의 출처는 몇 년 전에 저장된 번역일 수 있다. 번역 메모리의 크기가 곧 품질을 의미하지 않는 이유다. 오래된 번역과 중복 문장, 잘못 정렬된 원문과 번역문을 정기적으로 정리하고, 제품명이나 스타일 변경이 기존 데이터에도 반영되는지 확인해야 한다.


참고 자료

스타일 가이드와 용어집, 번역 메모리가 모두 있어도 문맥이 없으면 정확한 번역이 어려울 수 있다. 특히 소프트웨어 번역가의 경우 완성된 화면을 보면서 작업하기보다 TMS 안에 나열된 문자열을 번역하는 경우가 많다. 번역 툴에 "charge" 단어 하나만 나타났다고 생각해 보자.


배터리를 ‘충전’하라는 의미일 수도 있고, 요금을 ‘청구’한다는 뜻일 수도 있다. 명사라면 ‘충전량’, ‘요금’ 또는 ‘혐의’를 뜻할 가능성도 있다. 원문은 하나지만 제품 안에서 필요한 번역은 전혀 다르다. 스크린샷, 기능 설명, 문자열 ID, 글자 수 제한, 이전 화면과 다음 화면에 관한 정보가 있다면 번역가는 훨씬 정확한 결정을 내릴 수 있다. 예컨대 게임이라면 캐릭터의 성별과 성격, 다른 인물과의 관계, 장면의 분위기를 설명하는 자료가, 동영상 자막이라면 영상이 큰 도움이 될 수 있다.


이런 참고 자료는 부가적인 친절이 아니라 번역 품질을 결정하는 언어 자산이다. 번역가에게 더 정확하게 번역해 달라고 요구하면서 제품에 관한 정보는 거의 제공하지 않는다면, 번역가는 언어를 옮기는 동시에 제품의 맥락까지 추측해야 한다.


질의 기록

번역 과정에서는 가이드에 없는 문제가 계속 나타난다. 새로운 기능명을 번역할 것인지 영어로 유지할 것인지, 마케팅팀이 선호하는 표현을 UI에도 적용할 것인지, 글자 수 때문에 승인 용어의 축약형을 사용할 수 있는지처럼 기존 규칙만으로 답하기 어려운 질문들이다. 문제는 질문에 한 번 답하는 것으로 끝나지 않는다. 이메일이나 메신저에서 결정된 내용이 공식 자산에 반영되지 않으면 몇 달 뒤 같은 질문이 다시 등장한다. 담당자가 바뀌면 결정의 존재 자체를 알기 어렵다.


실제로 한 프로젝트에서 특정 용어를 지역팀의 요청으로 변경했더라도 그 내용이 용어집에는 반영되지 않을 수 있다. 다음 프로젝트의 번역가는 기존 승인 용어를 그대로 사용하고, 지역팀은 “지난번에 이미 바꿨는데 왜 다시 돌아왔느냐”고 묻는다. 번역가는 제공받은 자산을 정확히 따랐지만 결과적으로 잘못된 사람처럼 보인다.


따라서 중요한 질의와 결정은 검색할 수 있는 형태로 기록하고, 필요한 경우 스타일 가이드와 용어집, 번역 메모리에 반영해야 한다. 결정 기록은 최종 답변뿐 아니라 변경의 이유와 적용 범위를 함께 남길 때 더 유용하다.


모든 자산이 자산은 아니다

많은 벤더 및 클라이언트 회사들이 스타일 가이드와 용어집, 번역 메모리 등 '자산'을 이미 가지고 있다. 그러나 파일이 '존재'한다는 것과 실제로 사용할 수 있는 자산이라는 것은 다르다. 스타일 가이드는 몇 년째 업데이트되지 않았고, 텀베이스에는 현재 사용하지 않는 제품명이 남아 있으며, 번역 메모리는 서로 다른 벤더가 만든 번역으로 중복되어 있을 수 있다. 지역팀에서 승인한 변경이 본사의 중앙 자산에는 반영되지 않거나, 새 벤더가 최신 파일에 접근하지 못하는 경우도 있다.


오래되고 부정확한 자산은 아무 자료가 없는 것보다 더 위험할 수 있다. 번역가와 벤더는 공식 자료이기 때문에 신뢰하지만, 그 안의 정보가 이미 유효하지 않다는 사실은 알기 어렵기 때문이다. 언어 자산을 실제 자산으로 만들려면 최소한 다음 질문에 답할 수 있어야 한다.

  • 이 자산의 소유자는 누구인가?
  • 누가 변경을 승인하는가?
  • 어떤 버전이 최신인가?
  • 변경 사항은 번역가와 벤더에게 어떻게 전달되는가?
  • 지역팀과 리뷰어의 피드백은 어디에 반영되는가?
  • 더 이상 사용하지 않는 번역은 어떻게 폐기하는가?
  • 회사나 벤더가 바뀌어도 자산을 계속 사용할 수 있는가?

자산 관리는 문서를 한 번 만드는 프로젝트가 아니라, 번역과 리뷰에서 나온 결정을 다시 시스템에 돌려보내는 지속적인 과정이다.


언어 자산은 번역가의 일을 줄이기 위해서만 존재하지 않는다. 번역가와 리뷰어, 벤더, 클라이언트의 로컬라이제이션, 지역팀, 제품팀이 같은 기준을 공유하도록 만드는 조직의 기억에 가깝다. 이 기억이 없다면 새로운 프로젝트를 시작할 때마다 같은 용어를 다시 논의하고, 같은 질문에 다시 답하며, 이전에 수정했던 오류를 다시 발견하게 된다. 담당자나 벤더가 바뀔 때마다 제품의 목소리도 함께 달라질 수 있다.


로컬라이제이션에서 MT와 AI의 활용이 늘어날수록 언어 자산의 중요성은 오히려 커진다. AI는 자연스러운 문장을 빠르게 만들 수 있지만, 특정 회사가 어떤 기능명을 승인했는지, 사용자에게 어떤 어조로 말해야 하는지, 과거의 어떤 번역을 더 이상 사용하지 않는지는 스스로 알지 못한다. 명확하고 최신 상태의 자산이 없으면 AI는 더 빠른 속도로 서로 다른 표현을 만들어낼 뿐이다.


좋은 번역은 하나의 프로젝트를 완성한다. 잘 관리된 언어 자산은 그다음 프로젝트가 처음부터 다시 시작되지 않도록 한다.


번역 프로젝트가 문장을 남긴다면, 성숙한 로컬라이제이션 프로그램은 기억을 남긴다.


*


다음 이야기

→ [로컬라이제이션의 세계] #7 언어 자산 - 스타일 가이드(Style Guide)


#5


어떤 앱에서 영어로 다음과 같은 알림 메시지를 본다.

Updated 5 minutes ago.


그런데 동일한 앱의 한국어 화면에서는 이렇게 알람 메시지가 뜬다.

업데이트됨 5분 전


번역가의 실수일까? 99%의 확률로 번역가에게 다음과 같은 2개(혹은 3개)의 문장이 주어졌을 것이다.

Updated
{number} minutes ago


번역가는 서로 다른 문자열인 Updated를 “업데이트됨”으로, {number} minutes ago를 “{number}분 전”으로 옮겼을 것이다.


번역은 틀리지 않았다. 문제는 이 문자열들이 다른 언어를 받아들일 준비가 되어 있지 않았다는 것. 이처럼 번역만으로는 해결할 수 없는 문제를 예방하기 위해 필요한 과정이 인터내셔널라이제이션(Internationalization)이다. 흔히 사용하는 약어인 i18n은 단어의 첫 글자 i와 마지막 글자 n 사이에 18개의 글자가 있다는 데서 나왔다.


*

좋은 로컬라이제이션은 번역 전에 시작된다

인터내셔널라이제이션은 제품을 특정 언어나 문화의 구조에 종속되지 않도록 설계하는 과정이다. 쉽게 말하면, 번역을 시작하기 전에 제품이 여러 언어와 지역을 받아들일 수 있는 조건을 만드는 일이다.


서두의 예시보다도 더 흔히 볼 수 있는 예시로, 미국에서는 날짜를 8/30/2026으로 표시하지만 한국에서는 보통 2026. 8. 30.처럼 표시한다. 미국의 1,234.56과 일부 유럽 국가의 1.234,56은 같은 숫자를 나타내며, 통화 기호의 위치도 지역마다 다르다. 이런 형식을 화면에 직접 입력해 두면 번역가가 텍스트를 아무리 잘 옮겨도 현지 사용자에게 자연스러운 제품을 만들 수 없다.


문장의 길이도 달라진다. 영어의 짧은 버튼 하나가 독일어나 프랑스어에서는 훨씬 길어질 수 있고, 영어를 기준으로 고정된 버튼은 번역문을 전부 표시하지 못한다. 아랍어처럼 오른쪽에서 왼쪽으로 쓰는 언어는 화면의 방향 자체가 달라져야 한다. 사용하려는 글꼴에 한글이나 태국어 문자가 포함되어 있지 않아 글자가 네모로 표시되기도 한다.


이런 문제들은 겉으로는 제각각이지만 공통점이 있다. 번역의 문제가 아니라 제품 구조의 문제라는 점이다.


단어를 이어 붙이면 문장이 될까

소프트웨어 로컬라이제이션에서 특히 자주 만나는 문제 중 하나가 문자열 연결(string concatenation), 즉 여러 개의 짧은 문자열과 데이터를 코드에서 이어 붙여 하나의 문장을 만드는 방식이다.


영어로 다음과 같은 메시지를 만든다고 해보자.

"You have " + count + " new messages."


count가 5라면 화면에는 다음과 같이 표시된다.

You have 5 new messages.


영어에서는 아무 문제가 없어 보인다. 개발자 입장에서도 숫자만 바꾸면 되므로 간단하고 효율적인 구조처럼 느껴진다.

하지만 번역가에게는 문장 전체가 아니라 다음과 같은 조각만 전달될 수 있다.

You have
new messages.


한국어로는 “새 메시지가 5개 있습니다”처럼 숫자와 명사의 위치를 바꾸는 것이 자연스럽다. 그러나 문장이 코드에서 영어 순서로 조립된다면 번역가는 그 순서를 바꿀 수 없다. 각 조각을 정확하게 번역해도 완성된 문장은 어색해진다.


언어에 따라 문제는 더 복잡해진다. 영어는 수량에 따라 message와 messages를 구분하고, 다른 언어는 숫자에 따라 명사의 형태가 두세 가지 이상으로 달라지기도 한다. 성별이나 격에 따라 단어의 형태가 변하는 언어도 있다. 영어 문장 하나를 기준으로 고정한 구조가 모든 언어에서 그대로 작동할 것이라고 기대하기 어려운 이유다. 문장은 레고 블록처럼 단어를 같은 순서로 조립한다고 해서 완성되지 않는다. 언어마다 어순과 문법, 단어 사이의 관계가 다르기 때문이다.


문자열 연결은 왜 이렇게 자주 사용될까

그렇다고 문자열 연결이 단순한 실수라거나 무조건 부정적인 효과만 가져오는 것은 물론 아니다. 개발자는 같은 문구를 여러 번 작성하는 대신 작은 요소로 나누어 재사용하려 한다. 화면의 여러 메시지를 하나의 공통 컴포넌트로 만들고, 바뀌는 부분만 코드에서 삽입하면 개발과 유지 관리가 쉬워 보인다. 뿐만 아니라 번역할 문자열의 수를 줄이면 번역 비용도 절약할 수 있다.


무엇보다 제품이 영어로 먼저 개발되면 이 구조의 문제가 잘 드러나지 않는다. 영어 단어를 영어 어순으로 조립한 결과는 당연히 자연스럽다. 실제 번역을 넣거나 다른 언어로 테스트한 뒤에야 문제가 보인다.


실제 소프트웨어 스트링을 보다 보면 다음과 같은 스트링들을 어렵지 않게 만날 수 있다.

"Delete " + itemName
"Updated " + number + " minutes ago"
userName + " shared " + fileName + " with you"


영어에서는 모두 자연스럽다. 그러나 다른 언어에서는 목적어가 동사보다 앞에 와야 하거나, 숫자에 따라 시간 단위가 달라지거나, 사용자 이름과 파일 이름에 조사나 격변화가 필요할 수 있다.


개별 문자열만 번역하는 사람은 최종 문장이 어떻게 조립되는지 알기 쉽지 않은 경우가 많다. 번역가는 추측해서 작업하고, 문제는 제품 테스트 단계에서야 발견된다. 그때는 번역을 고치는 것만으로 해결할 수 없어 개발팀에 코드 수정을 요청해야 한다.


플레이스홀더는 해결책이자 또 다른 문제

문장 전체를 하나의 문자열로 제공하고, 변하는 정보만 플레이스홀더나 변수로 삽입하면 문자열 연결의 상당 부분을 피할 수 있다.

You have {count} new messages.


번역가는 이제 문장 전체를 보고 순서를 바꿀 수 있다.

새 메시지가 {count}개 있습니다.


플레이스홀더 자체는 문제가 아니다. 사용자 이름, 날짜, 수량처럼 실행할 때마다 달라지는 정보를 문장에 넣기 위해 반드시 필요한 기능이다. 문제는 플레이스홀더를 지나치게 많이 사용하거나, 변수 안에 문법적 의미를 가진 문장 조각까지 넣을 때 발생한다.


예를 들어 다음과 같은 극단적인 케이스를 생각해 볼 수 있다.

{user} {action} {count} {item}.


영문이라면 실제 화면에는 다음과 같이 나타날 수 있다.

Alex deleted 3 files.


하지만 번역가는 {action}에 deleted가 들어가는지, {item}이 files인지 알 수 없다. 설령 알고 있더라도 한국어에서는 “Alex님이 파일 3개를 삭제했습니다”처럼 어순과 조사까지 바꾸어야 한다. {action}과 {item}에 이미 번역된 문장 조각이 들어온다면 번역가가 전체 문법을 조정할 방법이 없다. 이것은 겉으로는 플레이스홀더를 사용했지만, 실제로는 문자열 연결과 같은 문제를 가진다. 코드 밖에서 문장을 이어 붙일 뿐이다.


다음과 같은 문자열도 흔히 볼 수 있다.

Your {0} has been {1} by {2}.


{0}, {1}, {2}가 무엇을 의미하는지 설명이 없다면 번역가는 완성된 문장을 상상해야 한다. 첫 번째 변수는 주문일 수도 있고 계정일 수도 있다. 두 번째에는 approved, rejected, deleted처럼 문법적 형태가 서로 다른 단어가 들어갈 수 있다. 세 번째가 사람인지 시스템인지 날짜인지도 알 수 없다.


변수가 많아질수록 하나의 번역으로 처리할 수 있는 경우의 수는 줄어든다. 기술적으로는 모든 조합이 가능해도, 언어적으로 모든 조합이 자연스러운 것은 아니다.


문자열과 변수를 안전하게 설계하려면

가장 기본적인 원칙은 사용자에게 하나의 메시지로 보이는 문장은 가능한 한 완전한 문장으로 번역하도록 제공하는 것이다.

나쁜 예
"Upload " + fileName + " complete"

나은 예
Upload of {fileName} is complete.


변수에는 사용자 이름, 파일명, 날짜, 숫자처럼 실제로 바뀌어야 하는 데이터만 넣는 것이 좋다. 동사, 전치사, 조사, 문장 종결 표현처럼 언어의 문법을 결정하는 요소를 변수로 만들면 번역 가능한 범위가 급격히 줄어든다.


변수의 이름도 중요하다.

이해하기 어려운 예
Your {0} was updated on {1}.

이해하기 쉬운 예
Your {accountName} was updated on {updateDate}.


여기에 각 변수의 실제 예시와 문장이 표시되는 화면에 대한 설명을 제공하면 번역가가 훨씬 정확하게 판단할 수 있다. 이상적인 상황이라면 스크린샷이나 디자인 링크도 함께 제공하는 것이 가장 좋다.


수량이나 성별에 따라 문장이 달라지는 경우에는 단순한 변수 대신 복수형과 문법적 조건을 처리할 수 있는 메시지 포맷을 사용해야 한다. 대표적으로 ICU MessageFormat은 숫자에 따라 서로 다른 문장을 선택하거나 언어별 어순을 조정할 수 있도록 지원한다. 영어에서는 다음 두 문장이 필요하다.

You have 1 new message.
You have 5 new messages.


한국어에서는 두 경우 모두 다음 구조를 사용할 수 있다.

새 메시지가 1개 있습니다.
새 메시지가 5개 있습니다.


중요한 것은 모든 언어에 영어와 같은 복수형 규칙을 강요하지 않는 것이다. 각 언어가 자체 문법에 따라 필요한 형태를 선택할 수 있어야 한다. 서로 다른 상황에서 우연히 영어 문구가 같다는 이유로 하나의 문자열을 재사용하는 것도 주의해야 한다. 영어의 Open은 파일을 여는 동사일 수도 있고 영업 중이라는 상태를 나타내는 형용사일 수도 있다. 영어에서는 같지만 다른 언어에서는 전혀 다른 단어가 필요할 수 있다. 의미와 맥락이 다르다면 별도의 문자열로 관리하는 편이 안전하다.


번역 전에 문제를 발견하는 방법

인터내셔널라이제이션 문제를 출시 직전에 발견하면 작은 문구 하나를 고치기 위해 코드와 디자인, 번역, 테스트를 다시 거쳐야 할 수 있다. 따라서 실제 번역이 시작되기 전에 문제를 발견하는 과정이 필요하다.


의사 현지화(pseudo-localization)는 원문을 인위적으로 길게 만들거나 특수문자를 넣어 화면에 표시하는 테스트 방식이다. 이를 통해 글자가 잘리는 버튼, 번역되지 않은 하드코딩 문자열, 지원되지 않는 문자, 잘못된 화면 정렬을 조기에 발견할 수 있다.


개발 단계에서 현지화 문자열 앞뒤에 다른 문자열을 직접 연결하는 코드를 탐지하거나, 지나치게 많은 변수가 포함된 문자열을 검토하는 규칙을 마련할 수도 있다. 로컬라이제이션팀이 디자인과 기능 기획 단계부터 참여하면 출시 직전에 발견되는 문제를 더욱 줄일 수 있다. 물론 모든 문장을 언어별로 따로 개발할 수는 없다. 목적은 변수를 없애거나 문자열을 무조건 늘리는 것이 아니라, 코드의 재사용성과 언어의 유연성 사이에서 균형을 찾는 것이다.


잘된 인터내셔널라이제이션은 눈에 띄지 않는다

인터내셔널라이제이션은 번역가나 로컬라이제이션팀만의 책임이 아니다. 개발자는 문자열과 데이터 구조를 설계하고, 디자이너는 번역문이 길어질 가능성을 고려하며, 콘텐츠 작성자는 여러 문화에서 이해할 수 있는 원문을 작성해야 한다. 로컬라이제이션팀은 각 언어에서 발생할 수 있는 문제를 미리 발견하고 이를 제품 요구사항으로 바꾸는 역할을 한다.


제대로 되지 않았을 때는 누구나 문제를 알아차린다. 글자가 잘리고, 날짜가 낯설며, 문장은 기계적으로 조립된 것처럼 보인다. 반대로 잘 되어 있을 때는 사용자가 그 존재를 의식하지 않는다. 제품이 처음부터 자신의 언어로 만들어진 것처럼 자연스럽게 느껴질 뿐이다.


로컬라이제이션은 완성된 제품에 번역을 덧붙이는 마지막 단계가 아니다. 좋은 로컬라이제이션은 첫 문장이 번역되기 훨씬 전, 제품이 다른 언어를 받아들일 수 있는 구조를 만드는 순간부터 시작된다.


*


다음 이야기

[로컬라이제이션의 세계] #6 언어 자산(Linguistic Assets)


#4

벤더에서 일할 때 클라이언트는 주로 이메일과 작업 요청의 형태로 존재할 뿐이었다.
 
프로젝트와 파일이 도착하고, 일정이 전달된다. 번역가가 질문을 보내면 프로젝트 매니저가 이를 정리해 클라이언트에게 전달한다. 한참 뒤 답변이 돌아오기도 하고, 번역이 거의 끝나갈 무렵 원문이나 일정이 바뀌기도 한다.
 
그럴 때면 자연스럽게 의문이 생긴다. 왜 원문이 확정되기도 전에 번역을 시작했을까. 왜 번역이 진행 중인데 제품은 계속 바뀔까. 로컬라이제이션팀에서 답하면 될 것 같은 질문에 왜 여러 부서의 확인이 필요할까.
 
클라이언트 사이드로 자리를 옮긴 뒤에야 그 질문들의 답이 조금씩 보이기 시작했다. 벤더에게 하나의 작업을 보내기 전부터 클라이언트 안에서는 이미 많은 사람이 움직인다. 제품의 방향을 정하는 사람, 기능을 개발하는 사람, 원문을 작성하는 사람, 출시 시장과 일정을 결정하는 사람, 법적 위험을 검토하는 사람까지 각자의 조건과 우선순위를 가지고 하나의 제품에 관여한다.
 
로컬라이제이션팀은 완성된 제품을 넘겨받아 번역을 완성하는 팀이 아니다. 이 여러 팀 사이에서 글로벌 사용자에게 필요한 조건을 만들고, 아직 완성되지 않은 제품이 여러 언어로 출시될 수 있도록 연결하는 팀에 가깝다.
 

*

로컬라이제이션팀은 어디에 있을까

제일 먼저 짚고 넘어가야 할 것은 클라이언트마다 로컬라이제이션팀의 규모와 형태는 천차만별이라는 것이다. 대규모 글로벌 기업에는 로컬라이제이션 전담 조직이 있고, 그 안에서도 프로그램 관리, 언어 품질, 엔지니어링과 벤더 관리 등의 역할이 나뉠 수 있다. 반면 규모가 작은 회사에서는 프로덕트 매니저나 마케팅 담당자가 로컬라이제이션을 함께 관리한다. 전담자가 있더라도 한 사람이 프로젝트 운영, 벤더, 품질과 예산을 모두 책임지기도 한다.
 
로컬라이제이션팀이 회사의 어느 조직에 속하는지도 제각각이다. 제품과 소프트웨어가 중심인 기업에서는 프로덕트나 엔지니어링 조직 아래에 있는 경우가 많다. 마케팅 콘텐츠의 비중이 큰 회사에서는 마케팅이나 콘텐츠 조직에 속할 수 있다. 글로벌 시장 진출이 핵심 목표라면 인터내셔널, 글로벌 오퍼레이션 또는 그로스(Growth) 조직의 일부가 되기도 한다. 고객 지원이나 문서 콘텐츠가 중심이면 커스터머 익스피리언스 조직에 포함될 수도 있다.
 
팀이 놓인 자리는 단순한 조직도의 문제가 아니다. 그 회사가 로컬라이제이션을 어떻게 바라보는지를 보여준다. 프로덕트 조직에 있다면 제품 개발 초기부터 국제화와 글로벌 사용자 경험에 관여하기 쉽다. 마케팅 조직에 있다면 브랜드와 시장별 콘텐츠 전략이 우선될 수 있다. 오퍼레이션 아래에서는 비용, 처리량과 프로세스 효율이 주요 지표가 될 가능성이 크다.
 
물론 정답이 있는 문제가 아니며, 어디에 속하는 것이 반드시 더 좋다고 말할 수는 없다. 다만 로컬라이제이션을 출시 직전의 번역을 처리하는 작업으로만 보는 회사와 글로벌 제품을 만드는 핵심 역량으로 보는 회사에서 팀의 권한과 역할이 같을 수는 없을 것이다.
 

클라이언트 로컬라이제이션팀의 사람들

클라이언트 사이드에서 가장 흔히 볼 수 있는 역할은 로컬라이제이션 프로젝트 매니저 또는 프로그램 매니저다.
 
벤더 PM이 전달받은 콘텐츠를 일정과 예산에 맞춰 번역하고 납품하는 과정을 관리한다면, 클라이언트 PM은 어떤 콘텐츠를 왜 현지화해야 하는지부터 살펴야 한다. 제품팀의 출시 계획을 파악하고, 필요한 언어와 작업 범위를 정하고, 내부 일정과 벤더의 작업 일정을 연결한다. 번역 중 발생한 질문은 제품 담당자나 개발자, 콘텐츠 작성자 등 답을 가진 사람에게 전달한다. 번역이 제품에 적용된 뒤에는 테스트와 수정을 거쳐 실제 출시까지 이어지도록 관리한다.
 
프로그램 매니저는 개별 프로젝트보다 더 큰 운영 구조를 본다. 지원 언어와 벤더 전략을 세우고, 번역 관리 시스템과 자동화 프로세스를 구축하며, 비용과 품질 지표를 관리한다. 콘텐츠의 중요도와 위험에 따라 전문 번역, 기계 번역, 리뷰와 테스트를 어떻게 조합할지도 결정한다. 한 기업의 로컬라이제이션 프로그램의 전략적 방향을 수립하고, 다른 내부 관계자 및 리더십과의 교류를 통해 새로운 기회를 발굴하고 로컬라이제이션 프로그램의 가치를 알리고 세일즈하는 자리이기도 하다.

또 다른 중요한 역할로 벤더 매니저와 퀄리티 매니저도 빠질 수 없다. 벤더 매니저는 프로젝트에 적합한 번역 업체를 선정하고 온보딩하며, 계약과 비용, 작업 역량, 성과를 관리한다. 단순히 작업을 발주하는 데 그치지 않고, 여러 언어와 프로젝트에 필요한 리소스를 안정적으로 확보하고 벤더와 장기적인 협업 관계를 만드는 역할이다.

퀄리티 매니저는 번역의 품질 기준을 세우고 그것이 실제 결과물에 일관되게 적용되는지를 살핀다. 스타일 가이드와 용어집을 관리하고, 리뷰와 품질 평가 방식을 설계하며, 반복되는 오류의 원인을 찾아 번역가와 벤더, 내부 리뷰어에게 피드백이 돌아가도록 한다. 팀의 규모에 따라 벤더 관리와 품질 관리, 프로젝트 운영을 한 사람이 함께 맡기도 한다.
 
회사에 따라 특정 언어의 품질을 담당하는 랭귀지 매니저 랭귀지 리드가 있을 수 있다. 이들은 핵심 용어의 번역을 결정하고 용어집과 스타일 가이드를 관리한다. 벤더의 번역을 검토하고, 해당 시장의 사용자에게 자연스럽고 브랜드에 맞는 언어인지 판단한다. 
 
인터내셔널라이제이션 엔지니어, 글로벌라이제이션 엔지니어 또는 로컬라이제이션 엔지니어가 기술적인 기반을 담당하기도 한다. 제품의 텍스트가 번역 가능한 형태로 관리되는지 확인하고, 번역 관리 시스템과 제품의 콘텐츠 시스템을 연결한다. 날짜와 통화 형식, 복수형, 오른쪽에서 왼쪽으로 쓰는 언어 등 다양한 언어와 지역을 제품이 제대로 지원하도록 만든다.
 
다만 위에서도 말했듯 이 구성은 클라이언트 회사마다 제각각이고, 솔직한 말로 압도적 다수의 회사들에서 로컬라이제이션팀은 존재감이 거의 없거나 그리 크지 않은 편이다. 내가 경험한 회사들과 업계 동료들의 이야기를 종합해 보면, 대기업에서도 로컬라이제이션팀이 놀라울 정도로 적은 인원으로 운영되거나 다른 부서의 이해도가 현저히 낮은 경우가 많다.

내 경험을 놓고 얘기하자면, 이전에 근무했던 중간 규모의 게임 스튜디오는 지금의 회사보다 규모는 훨씬 작았다. 그러나 게임에서 언어와 문화적 경험은 플레이어의 몰입과 제품의 성패에 직접 영향을 미치는 요소였기 때문에 로컬라이제이션팀의 규모나 다른 팀의 이해도도 상당했다. 반대로 지금 근무하는 회사는 훨씬 큰 기업이지만, 2년 전 내가 처음 합류했을 때만 해도 팀의 규모가 5명 미만 수준이었고, 다른 팀 사이에서도 그 존재를 모르는 경우도 제법 있었다.

회사의 규모가 크다고 해서 반드시 로컬라이제이션 조직도 크거나 성숙한 것은 아니라는 것. 로컬라이제이션팀의 영향력은 회사의 크기보다, 그 회사가 글로벌 사용자 경험에서 로컬라이제이션의 가치를 얼마나 중요하게 인식하고 있는지에 더 크게 좌우된다.

로컬라이제이션팀과 함께 일하는 사람들

클라이언트 사이드의 로컬라이제이션은 전담팀 안에서만 이루어지지 않는다. 아래에 소개하는 직무와 팀이 모두 로컬라이제이션을 본업으로 하는 것은 아니다. 그러나 로컬라이제이션팀에서 일하면 높은 확률로 협업하게 되는 사람들이다.
 
프로덕트 매니저는 어떤 기능을 언제, 어느 시장에 출시할지 결정한다. 새로운 기능에 어떤 콘텐츠가 포함되는지, 지원 국가는 어디인지에 따라 로컬라이제이션의 범위와 일정도 달라진다. 로컬라이제이션팀이 제품 개발 초기에 참여하지 못하면 영어 제품이 거의 완성된 뒤 촉박한 일정으로 번역 요청을 받게 될 가능성이 커진다.
 
소프트웨어 엔지니어는 제품이 여러 언어를 기술적으로 지원할 수 있도록 만든다. 텍스트를 코드에서 분리하고, 각 언어의 날짜·숫자·통화 형식을 처리하며, 번역된 콘텐츠가 제품에 제대로 표시되도록 구현한다. 화면에서 문장이 잘리는 문제가 반복된다면 번역을 줄이는 대신 디자인이나 코드를 수정해야 할 수도 있다.
 
UX 라이터콘텐츠 디자이너는 제품 안의 버튼, 메뉴, 오류 메시지와 안내 문구를 작성한다. 테크니컬 라이터는 도움말과 사용 설명서를 만든다. 명확하고 일관된 원문은 좋은 번역의 출발점이다. 반대로 맥락 없는 한두 단어와 모호한 문장은 번역가에게 추측을 요구한다.
 
마케팅팀과 지역 담당팀은 광고, 캠페인, 이메일과 앱스토어 콘텐츠를 현지 시장에 맞게 조정한다. 이들은 현지의 문화와 사용자 반응을 가장 가까이에서 이해하지만, 한 시장의 효과를 우선하는 지역팀과 여러 언어의 일관성과 확장성을 관리하는 로컬라이제이션팀의 관점이 다를 때도 있다.
 
이건 나도 직접 경험했고 지금도 경험하는 바인데, 본사 로컬라이제이션팀과 지역 마케팅팀 또는 지역 오피스 사이에는 때때로 일종의 묘한 긴장감이 존재한다. 지역팀은 본사에서 번역한 문구가 현지에서는 자연스럽지 않거나 충분히 효과적이지 않다고 느끼고, 본사팀은 지역별 수정이 쌓이면서 브랜드 메시지와 용어의 일관성이 무너지는 것을 우려한다. 지역팀의 입장에서는 현지 시장을 가장 잘 아는 자신들에게 더 많은 결정권이 필요하고, 본사팀의 입장에서는 모든 시장이 각자의 방식으로 움직일 경우 품질과 일정, 비용을 체계적으로 관리하기 어려워진다.
 
결국 이 긴장은 어느 한쪽이 틀려서라기보다 서로 다른 범위의 책임에서 비롯된다. 지역팀은 하나의 시장을 깊이 보고, 본사 로컬라이제이션팀은 여러 시장을 동시에 바라본다. 중요한 것은 어느 쪽의 의견을 일방적으로 따르는 것이 아니라, 지역팀의 전문성을 활용하면서도 변경 사항이 용어집과 번역 메모리, 향후 콘텐츠에 다시 반영될 수 있는 협업 구조를 만드는 일이다.
 
QA와 테스팅팀은 번역된 콘텐츠가 실제 제품에서 제대로 작동하는지 확인한다. 문장이 화면 밖으로 잘리거나 영어가 남아 있는 문제, 잘못된 날짜와 통화 형식, 특정 언어에서만 발생하는 기능 오류 등을 찾는다. 언어 자체의 문제를 확인하는 LQA는 내부에서 수행하거나 전문 벤더에 맡길 수 있다.
 
법무와 정책 담당팀은 이용 약관, 개인정보 보호, 소비자 고지와 지역별 규제에 관련된 내용을 검토한다. 짧은 문장 하나도 법적 책임이나 사용자 동의와 관련되어 있다면 로컬라이제이션팀이 혼자 결정할 수 없다. 클라이언트의 답변이 늦어지는 이유는 답을 무시해서가 아니라, 답을 가진 사람이 한 명이 아니기 때문일 때가 많다.
 
구매팀은 외부 LSP의 선정과 계약, 등을 로컬라이제이션팀과 함께 분담하곤 한다. 로컬라이제이션팀이 언어 품질과 운영 역량을 우선한다면 구매팀은 가격, 보안, 계약 조건과 회사 전체의 공급업체 전략을 함께 고려한다.
 
로컬라이제이션팀은 이처럼 서로 다른 목표와 언어를 사용하는 팀들 사이에 놓여 있다. 그렇기에 언어와 언어 사이의 번역만큼이나, 어쩌면 그 이상으로 부서와 부서 사이를 번역하는 능력이 필요하다.
 

AI와 함께 달라지는 클라이언트 사이드의 역할

지금까지 이야기한 것들이 전통적인 클라이언트 사이드의 구조였다면, 지난 몇 년 사이 AI의 부상은 클라이언트 사이드 로컬라이제이션팀의 위치를 빠르게 바꾸고 있다. 이전에는 번역 요청을 접수하고 벤더에 전달한 뒤 납품을 관리하는 운영 업무가 팀의 큰 비중을 차지했다. 이제 기계 번역과 대규모 언어 모델, 자동 품질 평가와 워크플로 자동화가 발전하면서 이런 작업들의 많은 부분이 자동화되거나 훨씬 더 효율적으로 처리할 수 있게 되었다.
 
그렇다고 로컬라이제이션팀의 필요가 단순히 줄어든 것은 아니다. 오히려 무엇을 자동화할지, 어떤 콘텐츠에 사람의 검토가 필요한지, 품질과 브랜드 기준을 어떻게 적용할지 결정하는 일이 중요해졌다. 어떤 모델과 데이터를 사용할지, 회사의 콘텐츠를 외부 AI 도구에 입력해도 되는지, 결과물의 오류와 편향을 어떻게 평가할지에는 보안, 법무와 엔지니어링팀의 협력이 필요하다. AI가 만든 문장을 대량으로 생산하는 것보다 신뢰할 수 있는 방식으로 운영하고 통제하는 일이 더 어려울 수 있다.
 
이에 따라 클라이언트 로컬라이제이션팀의 역할도 번역 운영에서 언어 기술과 품질 거버넌스, 시스템 설계와 글로벌 콘텐츠 전략으로 넓어지고 있다. 팀이 단순한 번역 요청 창구에 머물면 비용 절감의 대상으로 보이기 쉽다. 반대로 여러 언어의 데이터와 품질, 문화적 위험을 이해하는 조직으로 자리 잡는다면 회사가 AI를 활용해 글로벌 콘텐츠를 만드는 과정에 중요한 전문성을 제공할 수 있다. AI는 이러한 변화를 처음 만든 원인이라기보다, 이미 진행되고 있던 변화를 크게 가속한 계기에 가깝다.
 

클라이언트에서 바라본 로컬라이제이션

벤더에서 가장 가까이 보였던 것이 납기와 품질이었다면, 클라이언트에서는 우선순위와 의사결정의 과정을 더 가까이 보게 된다.
 
모든 요청이 중요해 보여도 인력과 예산은 한정되어 있다. 제품팀은 빠른 출시를 원하고, QA팀은 테스트 시간이 더 필요하다고 말한다. 마케팅팀은 캠페인 날짜를 이미 정했고, 법무팀의 승인도 받아야 한다.
 
로컬라이제이션팀은 이런 조건 속에서 여러 언어의 사용자가 제품을 이용할 수 있는 길을 만든다. 벤더에 충분한 맥락을 제공하고 싶어도 내부 결정이 아직 끝나지 않았을 수 있다. 넉넉한 작업 시간을 주고 싶어도 로컬라이제이션팀 역시 프로젝트에 뒤늦게 초대받았을 수 있다. 제품의 문제를 발견하더라도 현실적으로 직접 코드나 출시 일정을 바꿀 권한이 없는 경우가 많다.
 
그렇다고 다른 팀의 결정을 기다리는 역할에 머물 수는 없다. 어떤 정보가 언제 필요한지 미리 알리고, 번역과 테스트 시간을 제품 계획에 반영하도록 설득해야 한다. 반복되는 문제를 데이터로 보여주고, 프로세스와 제품을 바꿀 사람을 찾아야 한다. 글로벌 사용자에게 문제가 될 수 있는 요소를 출시 전에 발견하고, 때로는 이미 정해진 결정에 이의를 제기해야 한다.
 
벤더에서 일할 때는 클라이언트가 답을 가진 사람이라고 생각했다. 클라이언트 사이드로 옮긴 뒤에는 답을 찾기 위해 누구에게 무엇을 물어야 하는지 알아내는 것이 업무의 큰 부분이라는 사실을 알게 되었다.
 
테이블의 양쪽은 서로 다른 풍경을 본다. 클라이언트는 제품의 맥락과 방향을 제공하고, 벤더는 언어와 시장, 대규모 운영에 필요한 전문성을 더한다. 어느 한쪽만으로 전체 과정이 완성되지는 않는다. 그리고 그 사이에는 서로 다른 언어뿐 아니라, 서로 다른 팀과 목표를 연결하는 사람들이 있다.
 

*

 
다음 이야기
[로컬라이제이션의 세계] #5 인터내셔널라이제이션에 대하여

출처: Slator

 
로컬라이제이션 업계의 또 하나의 대형 인수 소식이 전해졌다.
 
그 주인공은 역시나(?) RWS. 이번에는 프랑스의 언어 및 콘텐츠 서비스 기업 Acolad의 모회사 Acogroup을 인수하기 위한 계약을 체결했다고 발표했다. 아직 인수가 완료된 것은 아니고, 프랑스에서 필요한 정보 제공 및 협의 절차와 규제 당국의 승인 등을 거쳐야 하며, 거래 완료 예상 시점은 2027년 3월 31일. 그전까지 RWS와 Acolad는 별개의 회사로 운영된다.
 

RWS와 Acolad는 어떤 회사?

RWS는 로컬라이제이션과 번역 기술, 지식재산권 및 특허 번역 분야에서 오랜 역사를 가진 글로벌 기업이다. 무엇보다 공격적인 대형 인수합병을 통해 사업 영역을 확장해 온 기업이기도 하다. 2017년에는 생명과학 전문 업체 LUZ, 글로벌 로컬라이제이션 업체 Moravia를 인수했고, 2020년에는 업계의 대표적인 언어·콘텐츠 기술 기업 SDL을 인수했다. 이 과정에서 Trados와 Language Weaver를 비롯한 언어 기술도 RWS의 포트폴리오에 포함됐다. 최근에는 스스로를 ‘글로벌 AI 솔루션 기업’으로 소개하며 기존 언어 서비스 회사에서 기술 중심의 AI 파트너로 사업 정체성을 확장하고 있다.
 
Acolad 역시 유럽을 기반으로 성장한 대형 언어 및 콘텐츠 서비스 기업이다. Acolad, TextMaster와 Ubiqus 등의 브랜드를 통해 로컬라이제이션, 통역, 트랜스크립션과 콘텐츠 서비스를 제공한다. Acolad에 따르면 현재 유럽 1위, 전 세계 상위 10위권의 언어 및 콘텐츠 서비스 기업으로 자리 잡고 있다. 특히 규제 산업과 공공 부문, 통역 및 의료기기 분야에 강점을 가진 것으로 알려져 있다. 이번 거래가 완료되면 RWS는 Acolad이 보유한 서유럽 지역의 고객 기반과 약 1,200명의 직원, 22개국에 걸친 사업 네트워크를 확보하게 된다.
 

이번 인수의 주목할 점

첫 번째는 대형 LSP 사이의 합병과 인수가 계속되고 있다는 점이다. Acolad 자체도 십여 차례의 인수를 거쳐 성장한 기업이다. RWS 역시 2020년 SDL과의 대규모 합병을 비롯해 기술과 서비스를 보완하기 위한 인수를 이어왔다. 여러 언어와 콘텐츠 유형을 한 번에 처리하려는 글로벌 고객의 요구가 커지면서 대형 LSP는 규모, 지역별 인력과 기술 플랫폼을 함께 확보하려 한다. 이번 거래 역시 RWS의 글로벌 규모와 기술에 Acolad의 유럽 고객 기반과 현지 전문성을 더하는 성격이 강하다.
 
두 번째는 두 회사 모두 이번 인수를 설명하면서 AI를 전면에 내세우고 있다는 점이다. RWS는 Acolad의 고객들에게 자사의 Cultural Intelligence Layer와 Language Weaver Pro를 비롯한 AI 플랫폼을 제공할 기회가 확대될 것이라고 설명했다. Acolad도 양사의 결합을 통해 고객들이 AI 기반 콘텐츠 워크플로를 안전하고 책임감 있게, 더 큰 규모로 도입할 수 있을 것이라고 밝혔다. 표면적으로는 두 언어 서비스 기업의 결합이지만, 실제 발표에서 강조되는 것은 번역 물량이나 지원 언어 수만이 아니다. AI 플랫폼, 데이터와 콘텐츠 워크플로, 규제 산업 전문성, 기업 고객과의 장기적인 관계가 거래의 핵심 자산으로 언급된다.
 

출처: RWS
출처: acolad


달라지는 ‘번역 회사’의 의미

최근 대형 LSP의 홈페이지를 방문하면 ‘번역’보다 AI, 데이터, 플랫폼과 글로벌 콘텐츠 관리라는 표현이 더 앞에 등장하는 경우가 많다. 기업 안에서 계속 생산되는 콘텐츠를 여러 시장에 빠르게 배포하고, 기존 시스템과 연결하며, AI를 적용하되 품질과 보안을 관리할 방법을 함께 요구함에 따라, LSP들도 언어 서비스를 제공하는 회사를 넘어 기업의 다국어 콘텐츠와 AI 도입을 지원하는 기술 파트너로 자리매김하려 한다.
 
RWS의 Acolad 인수 추진은 이런 변화가 기업 소개 문구에만 머무르지 않고 실제 업계의 구조를 바꾸고 있다는 사례로 볼 수 있다. 한편으로는 대형 업체의 규모와 기술 경쟁력이 더욱 커지는 흐름이다. 다른 한편으로는 특정 언어와 시장, 분야에서 깊은 전문성을 가진 SLV와 독립 언어 전문가의 역할이 어떻게 달라질 것인지도 지켜볼 필요가 있다.
 
분명한 것은, 로컬라이제이션 업계에서 경쟁의 기준이 ‘누가 더 많은 언어를 더 빠르고 싸게 번역하는가’에서 ‘누가 언어, 콘텐츠와 AI를 하나의 시스템 안에서 매끄럽게 운영할 수 있는가’로 이동하고 있다는 것이다.


*
 

참고

+ Recent posts