번역 품질을 평가할 때 단순히 “좋다” 또는 “나쁘다”라고 판단하는 것만으로는 충분하지 않다. 특히 여러 언어와 벤더를 동시에 관리하는 로컬라이제이션 환경에서는 품질을 일관된 기준으로 분류하고 측정할 수 있는 방법이 필요하다. 이때 가장 대표적으로 사용되는 프레임워크 중 하나가 MQM(Multidimensional Quality Metrics)이다.
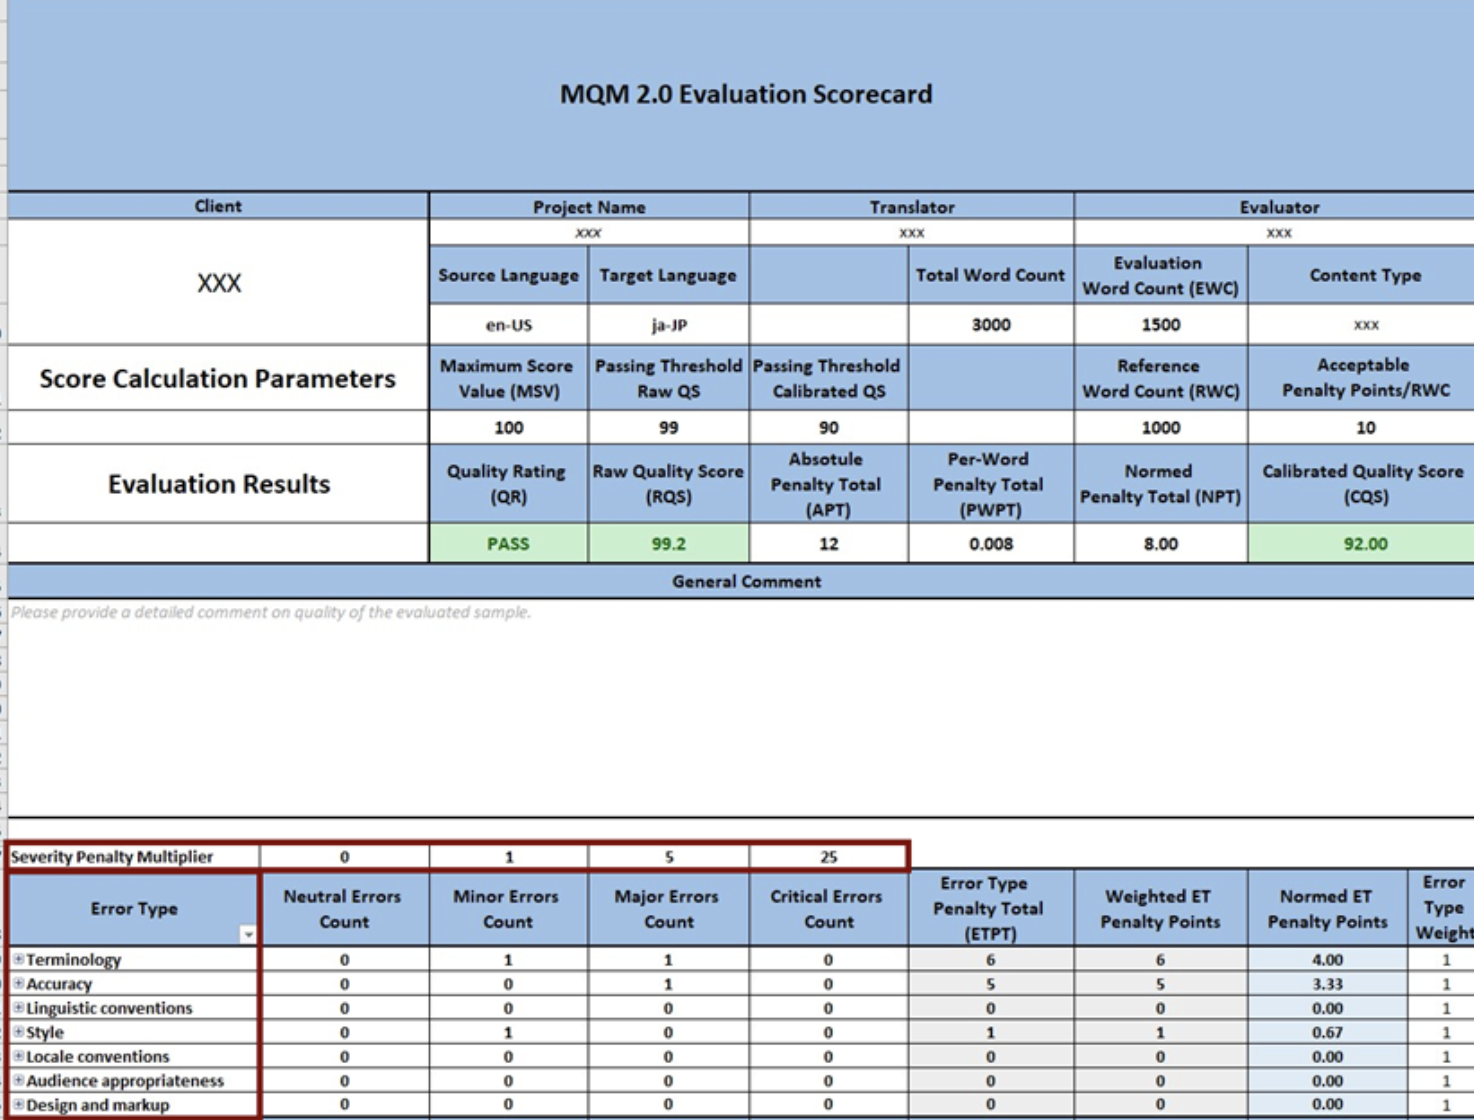
 

출처: MQM Council (https://www.themqm.org/mqm-pillars/the-mqm-scoring-models/)


MQM은 번역에서 발견되는 문제를 오류 유형(Error Type)오류 심각도(Severity)에 따라 분류하는 품질 평가 프레임워크다.


예를 들어 아래와 같은 번역이 있다면 문법적으로는 자연스럽지만 의미가 잘못 전달되었으므로 Accuracy → Mistranslation 오류로 분류할 수 있다.


Source: Delete account
Translation: 계정에서 로그아웃


반면, "계정을 삭제 할 수 있습니다."처럼 의미 전달에는 문제가 없지만 띄어쓰기가 잘못되었다면 Fluency 계열의 오류로 볼 수 있다. 즉, MQM은 모든 문제를 단순히 ‘오류 1건’으로 계산하는 것이 아니라 무엇이 잘못되었는지, 그리고 그 오류가 얼마나 중요한지를 구분한다.


MQM 대표 오류 유형

MQM은 계층적인 오류 분류법을 제공한다. 실제로는 프로젝트와 콘텐츠에 따라 필요한 항목을 선택하거나 세분화해서 사용할 수 있다.

유형 평가 대상 대표 세부 오류
Accuracy 원문의 의미가 정확하게 전달되었는가 Mistranslation, Omission, Addition
Terminology 적절하고 일관된 용어를 사용했는가 Wrong Term, Inconsistent Term
Fluency 번역문 자체가 언어적으로 올바른가 Grammar, Spelling, Punctuation
Style 요구되는 문체와 스타일을 따르는가 Register, Style Guide 위배
Locale Convention 해당 지역의 표기 관습을 따르는가 날짜, 시간, 숫자, 통화, 단위
Design & Markup 형식이나 구조에 문제가 없는가 Tag, Markup, Layout 문제


물론 모든 카테고리를 사용할 필요는 없다. 일반적인 소프트웨어 로컬라이제이션이라면 Accuracy, Terminology, Fluency, Style, Locale Convention 정도의 핵심 카테고리로 시작하고 필요에 따라 세분화하는 것도 흔하다.


오류의 심각도

같은 종류의 오류라도 사용자에게 미치는 영향은 다르다. 따라서 MQM에서는 오류 유형과 함께 심각도를 기록한다.

심각도 의미 예시
Minor 이해나 사용에 큰 영향을 주지 않는 오류 사소한 문법, 철자, 구두점 오류
Major 의미 전달이나 사용성에 상당한 영향을 주는 오류 중요한 오역, 잘못된 제품 용어
Critical 안전·법률·재정·데이터 등에 심각한 영향을 줄 수 있는 오류 안전 경고의 의미 반전, 법적 정보 오역


여기서 중요한 것은 오류의 양과 심각도가 반드시 비례하지 않는다는 점이다. 단어 하나가 잘못 번역되었더라도 사용자의 안전이나 데이터에 영향을 준다면 Critical 오류가 될 수 있다.


MQM 점수 계산

Severity에 가중치를 부여하면 번역 품질을 정량화할 수도 있다. 예를 들어 우리 팀에서 다음과 같이 가중치를 정했다고 가정해보자.


심각도 가중치
Minor 1
Major 5
Critical 25


1,000단어를 리뷰해서 Minor 3건, Major 2건이 발견되었다면 다음과 같이 페널티가 발생한다.

(3 × 1) + (2 × 5) = 13


이를 전체 단어 수로 정규화해 '1,000단어당 오류 점수'와 같은 내부 품질 지표를 만들 수도 있다. 다만 MQM이 특정한 가중치나 하나의 절대적인 Pass/Fail 점수를 강제하는 것은 아니다. 조직은 콘텐츠의 특성과 품질 목표에 맞게 점수 산정 모델과 Pass/Fail 기준을 설계할 수 있다.


MQM의 활용

MQM 데이터가 축적되면 단순한 번역 검수를 넘어 다양한 품질 분석이 가능하다.

언어별 품질 추적 한국어와 일본어의 분기별 Quality Score 비교
Vendor Performance 벤더별 Accuracy/Major 오류율 비교
Error Trend 분석 Terminology 오류가 지속적으로 증가하는지 확인
Root Cause Analysis 반복되는 오류가 번역, 용어집, 소스, 컨텍스트 중 어디에서 발생하는지 분석
MT/AI 평가 Human Translation, MT, LLM 번역의 오류 유형 비교


특히 MQM의 장점은 “품질이 낮다”에서 끝나지 않고 왜 품질이 낮은지를 데이터로 볼 수 있다는 것이다. Terminology 오류가 반복된다면 텀베이스를 개선할 수 있고, 여러 언어에서 동일한 Accuracy 오류가 발생한다면 번역가보다 원문 자체나 맥락 제공 방식에 문제가 있을 가능성도 살펴볼 수 있다.


MQM의 장점과 단점

장점 단점
품질을 구조적으로 측정할 수 있다 리뷰에 시간과 비용이 든다
오류의 원인을 구체적으로 분석할 수 있다 리뷰어마다 판단 기준이 달라질 수 있다
언어·벤더·기간별 비교가 가능하다 지나치게 복잡한 세부 분류법은 운영하기 어렵다
프로젝트에 맞게 커스텀할 수 있다 점수가 번역의 모든 측면을 설명하지는 못한다
MT/AI 번역 평가에도 활용할 수 있다 리뷰어 트레이닝과 정렬 작업이 필요하다


MQM 활용 시 고려 사항

MQM을 도입한다고 해서 번역 품질이 자동으로 객관화되는 것은 아니다. 예를 들어 동일한 오류를 한 리뷰어는 Major라고 판단하고 다른 리뷰어는 Minor라고 판단한다면 두 사람이 만든 MQM 점수를 그대로 비교하기 어렵다.


특히 여러 언어를 평가할 때는


한국어 Quality Score: 82

일본어 Quality Score: 95


라는 결과가 실제 품질 차이인지, 아니면 한국어 리뷰어가 일본어 리뷰어보다 엄격하기 때문인지 구분하기 어려울 수 있다. 따라서 MQM을 안정적으로 운영하려면 명확한 오류의 정의와 심각도 기준, 실제 예시, Reviewer Training, 그리고 정기적인 리뷰어 평가 기준 정렬 작업(Reviewer Calibration)이 함께 필요하다.


리소스

MQM을 실제 품질 평가에 적용해보고 싶거나 더 자세하게 알아보고 싶다면 MQM Council 웹사이트를 참고해보길 추천하다. 오류 유형과 심각도를 실제 점수로 변환하는 방법부터 가중치, Pass/Fail 기준을 설정하는 방법까지 자세히 설명되어 있으며, 바로 활용해볼 수 있는 Excel 기반 MQM Scorecard도 무료로 제공한다. 처음부터 자체 평가표를 만드는 것보다 이 자료를 바탕으로 조직이나 프로젝트에 필요한 Error Type과 평가 기준을 조정해 보는 것도 좋은 출발점이 될 수 있다.


출처: DeepL


기계번역(Machine Translation, MT) 엔진이라고 하면 흔히 구글 번역이나 한국에서는 네이버 파파고를 먼저 떠올리는 경우가 많은데, 대중적으로 덜 알려진 MT 업체 중 업계의 대표주자 중 하나로 자리매김한 서비스가 있다. 바로 DeepL이다. 개인이 외국어 문장을 번역할 때 사용하는 웹 번역기로의 명성은 상대적으로 약하더라도, API나 CAT 툴에 연결해 MT 엔진으로 활용하거나 기업의 다국어 콘텐츠를 처리하는 용도로는 업계에서 상당히 유명하다. 그렇다면 DeepL은 정확히 어떤 서비스이고, 다른 번역 서비스와는 무엇이 다를까?


독일에서 시작한 번역 AI 서비스

DeepL⁠은 2017년 독일 쾰른에서 시작한 회사다. 처음에는 번역 서비스를 중심으로 출발했지만, 지금은 스스로를 단순한 ‘번역 서비스 회사’보다 Language AI 기업으로 정의하고 있다. 현재 DeepL에 따르면 전 세계 20만 개 이상의 비즈니스 팀과 수백만 명의 개인 사용자가 서비스를 이용하고 있다고 한다. 


DeepL이 초창기에 이름을 알린 가장 큰 이유는 역시 기계번역의 자연스러움이었다. 지금이야 어떤 기계번역 서비스를 사용해도 품질이 상당하지만, 과거 기계번역을 조금이라도 많이 사용해 본 사람이라면 이런 경험이 있을 것이다. 문법적으로 틀린 문장은 아닌데, 사람이 실제로는 절대 이렇게 말하지 않을 것 같은 번역 말이다. DeepL은 특히 유럽 언어를 중심으로 자연스러운 번역 결과로 좋은 평가를 받으면서 빠르게 알려졌다. 이후 지원 언어와 기능을 계속 확대했고, 현재는 한국어와 일본어, 중국어는 물론 아랍어, 힌디어, 베트남어 등 훨씬 폭넓은 언어를 지원한다. 실제로 나도 지난 몇 년 사용 경험이 꽤 있는 편인데, 한국어와 일본어 번역 수준이 매우 인상적이다. 


그러다가 난립하는 NMT(신경망 기반 전통 MT) 사이에서도 차별화하고자 했는지 현재 DeepL은 번역 모델 자체도 LLM(Large Language Model) 인프라를 기반으로 한다. DeepL은 자체 LLM을 번역에 특화해 사용하고 있으며, 특히 긴 텍스트의 번역 품질 개선을 강조하고 있다. 그래서 이제는 흔히 생각하는 ‘전통적인 기계번역’과 ‘생성형 AI 번역’ 사이의 경계도 점점 흐려지고 있다.


DeepL의 차별점 

출처: DeepL


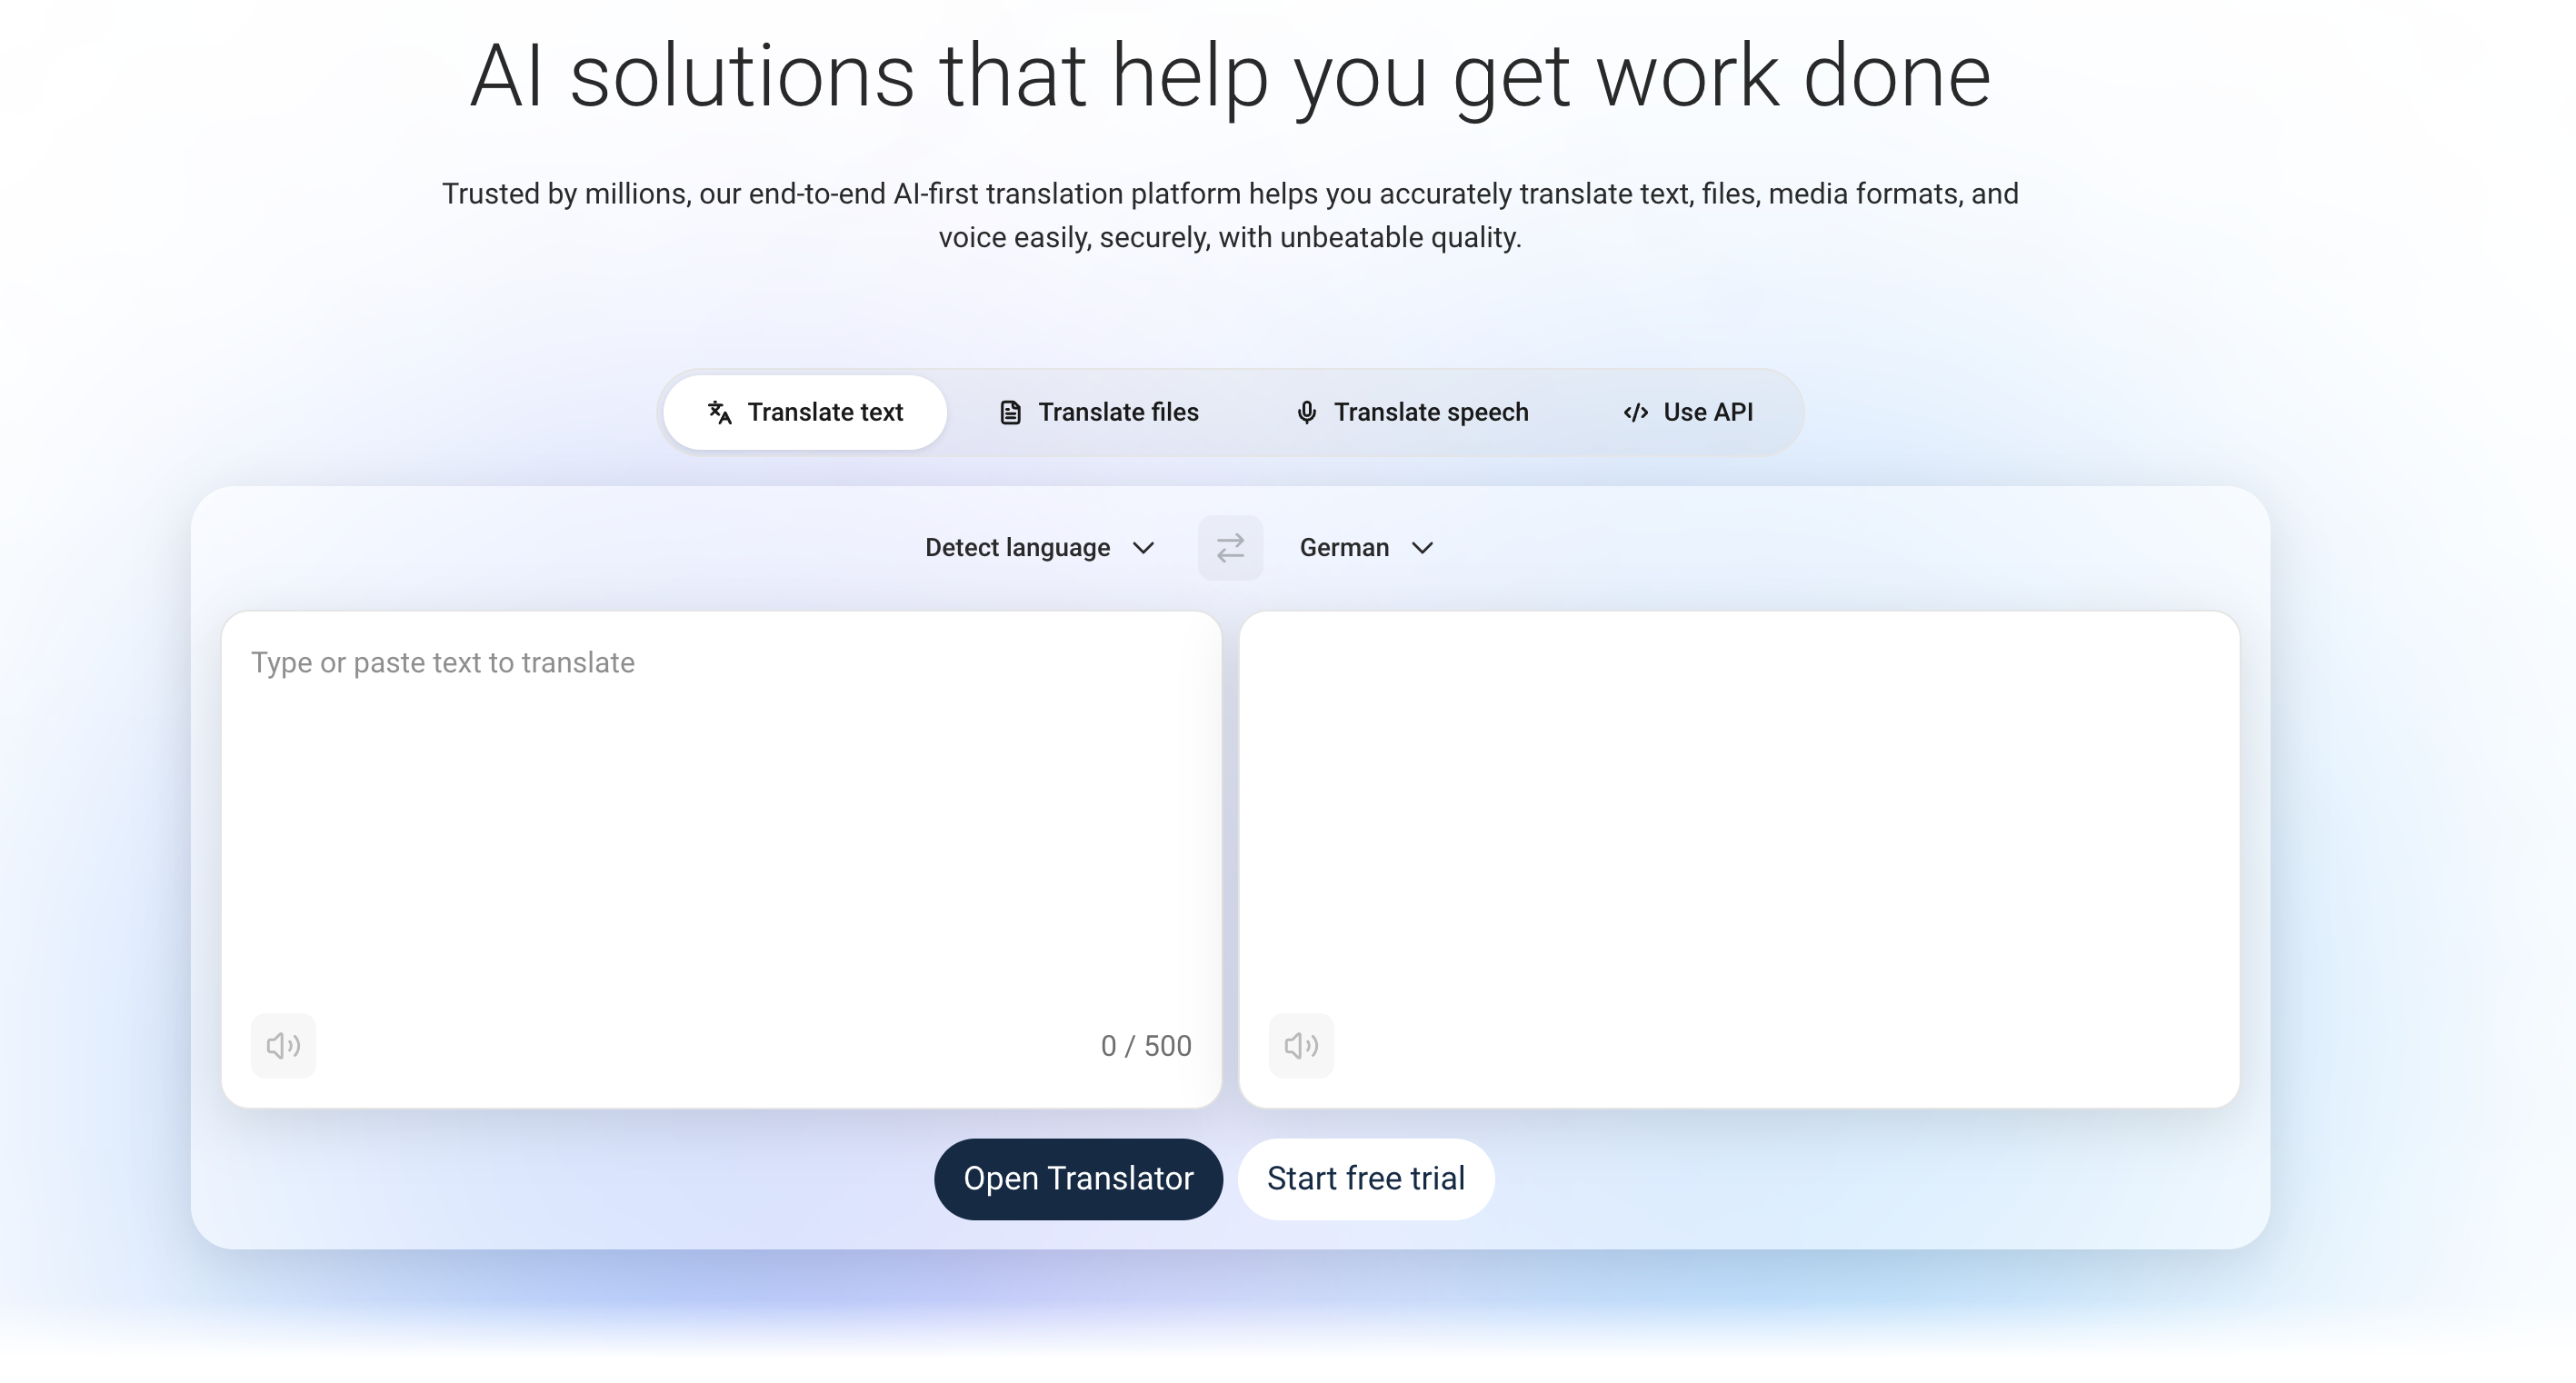
DeepL 웹사이트에 들어가 보면 사용법 자체는 매우 단순하다. 왼쪽에 원문을 입력하고 오른쪽에서 원하는 언어를 선택하면 된다. 이 점에서는 구글 번역이나 파파고와 크게 다르지 않다.


하지만 조금 더 살펴보면 로컬라이제이션 관점에서 흥미로운 기능들이 보인다. 대표적인 것이 문서 번역(Translate files)이다.

Word 문서나 PDF, PowerPoint 등의 파일을 업로드하면 문서의 원래 형식을 최대한 유지하면서 전체 문서를 번역할 수 있다. 단순히 텍스트를 복사해서 번역기에 붙여넣는 것보다 훨씬 편하다. 


출처: DeepL


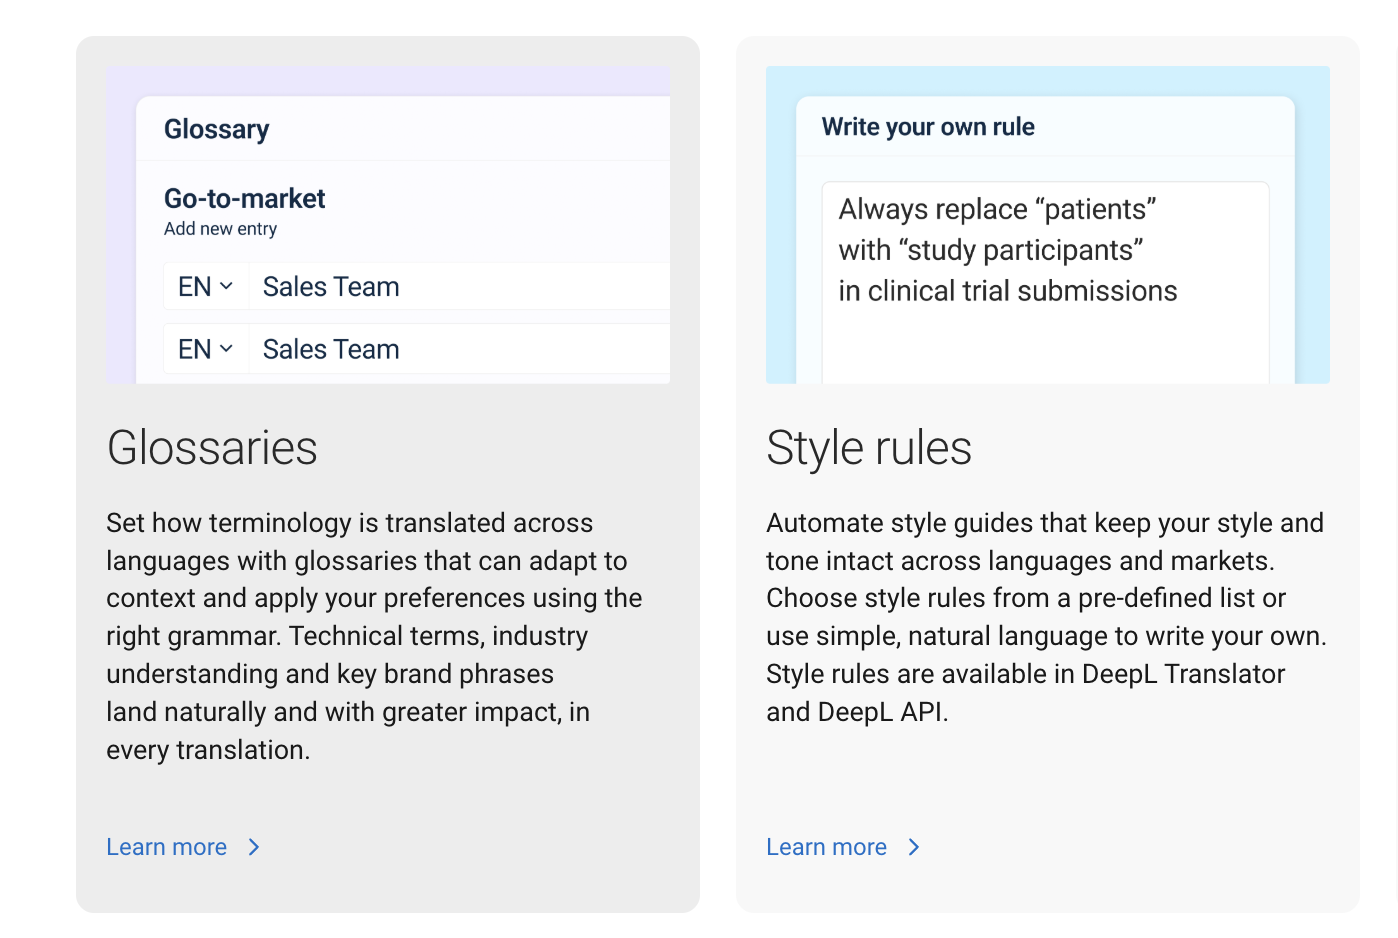
그보다 더 눈여겨볼 기능은 용어집(Glossaries)스타일 가이드(Style profiles/style rules)이다.

예를 들어 우리 회사의 제품에서 특정 기능의 이름은 번역하지 않고 영어 그대로 사용해야 한다고 하거나, '십시오'체가 아닌 '세요'체를 일관되게 사용해야 할 때, 일반적인 번역기에 문장을 넣으면 번역할 때마다 일관된 용어나 스타일을 사용한다는 보장이 없다. DeepL에서는 용어집과 스타일 가이드에 원하는 번역 결과에 반영할 수 있다. 단순한 검색·치환 방식이 아니라, LLM 기반으로 대상 언어의 문법에 맞게 용어를 적용한다는 것도 특징이다. 로컬라이제이션 실무에서 용어와 스타일의 일관성은 상당히 중요한 문제이기 때문에, 일상생활에 쓰이는 번역기와 전문적인 번역 워크플로의 차이가 보이는 지점이기도 하다.


또한 DeepL API를 트라도스 같은 CAT(Computer-Aided Translation) 툴이나 TMS(Translation Management System)에 연결하면 DeepL의 번역 결과를 그대로 사용하거나 검수 및 편집을 거쳐 사용할 수 있다. 즉, DeepL은 완성된 번역을 받아보는 서비스이기도 하지만, 전문적인 로컬라이제이션 환경에서는 번역 프로세스 안에 들어가는 하나의 MT 엔진이기도 하다. 여기에 한 발 더 나아가, 최근에는 별도의 CAT 툴이나 TMS를 거치지 않고도 번역 프로젝트를 관리할 수 있는 기능을 확장하며 간소화된 TMS에 가까운 플랫폼으로 진화하려는 움직임을 보이고 있다.


그럼 DeepL이 제일 좋은 MT 서비스일까?

DeepL이 자연스러운 번역으로 유명하다고 해서 모든 언어와 모든 콘텐츠에서 DeepL이 가장 좋은 결과를 낸다는 뜻은 당연히 아니다.

MT의 품질은 언어쌍에 따라 크게 달라질 수 있다. 같은 영어 원문이라도 독일어 번역에서 좋은 결과를 내는 엔진과 한국어 번역에서 좋은 결과를 내는 엔진이 반드시 같지는 않다.


콘텐츠의 성격도 중요하다. 제품 UI인지, 기술 매뉴얼인지, 마케팅 카피인지, 고객 지원 콘텐츠인지에 따라 요구되는 번역이 다르다. 특정 기업의 용어나 과거 번역 데이터를 얼마나 잘 활용할 수 있는지도 중요하고, 기업 환경이라면 데이터 보안과 API, 비용, 기존 TMS와의 연동 가능성까지 고려해야 한다.


그래서 실제 로컬라이제이션 업계에서는 단순히 어떤 엔진이 제일 좋다고 무조건 사용하기보다, 여러 MT 엔진으로 동일한 또 다양한 콘텐츠를 번역한 뒤 언어별 품질을 평가하는 MT 테스트/평가를 진행한다. 어떤 엔진이 가장 좋은지를 결정하는 것 역시 하나의 로컬라이제이션 작업인 셈이다.


*

단순하고 직관적인 UI


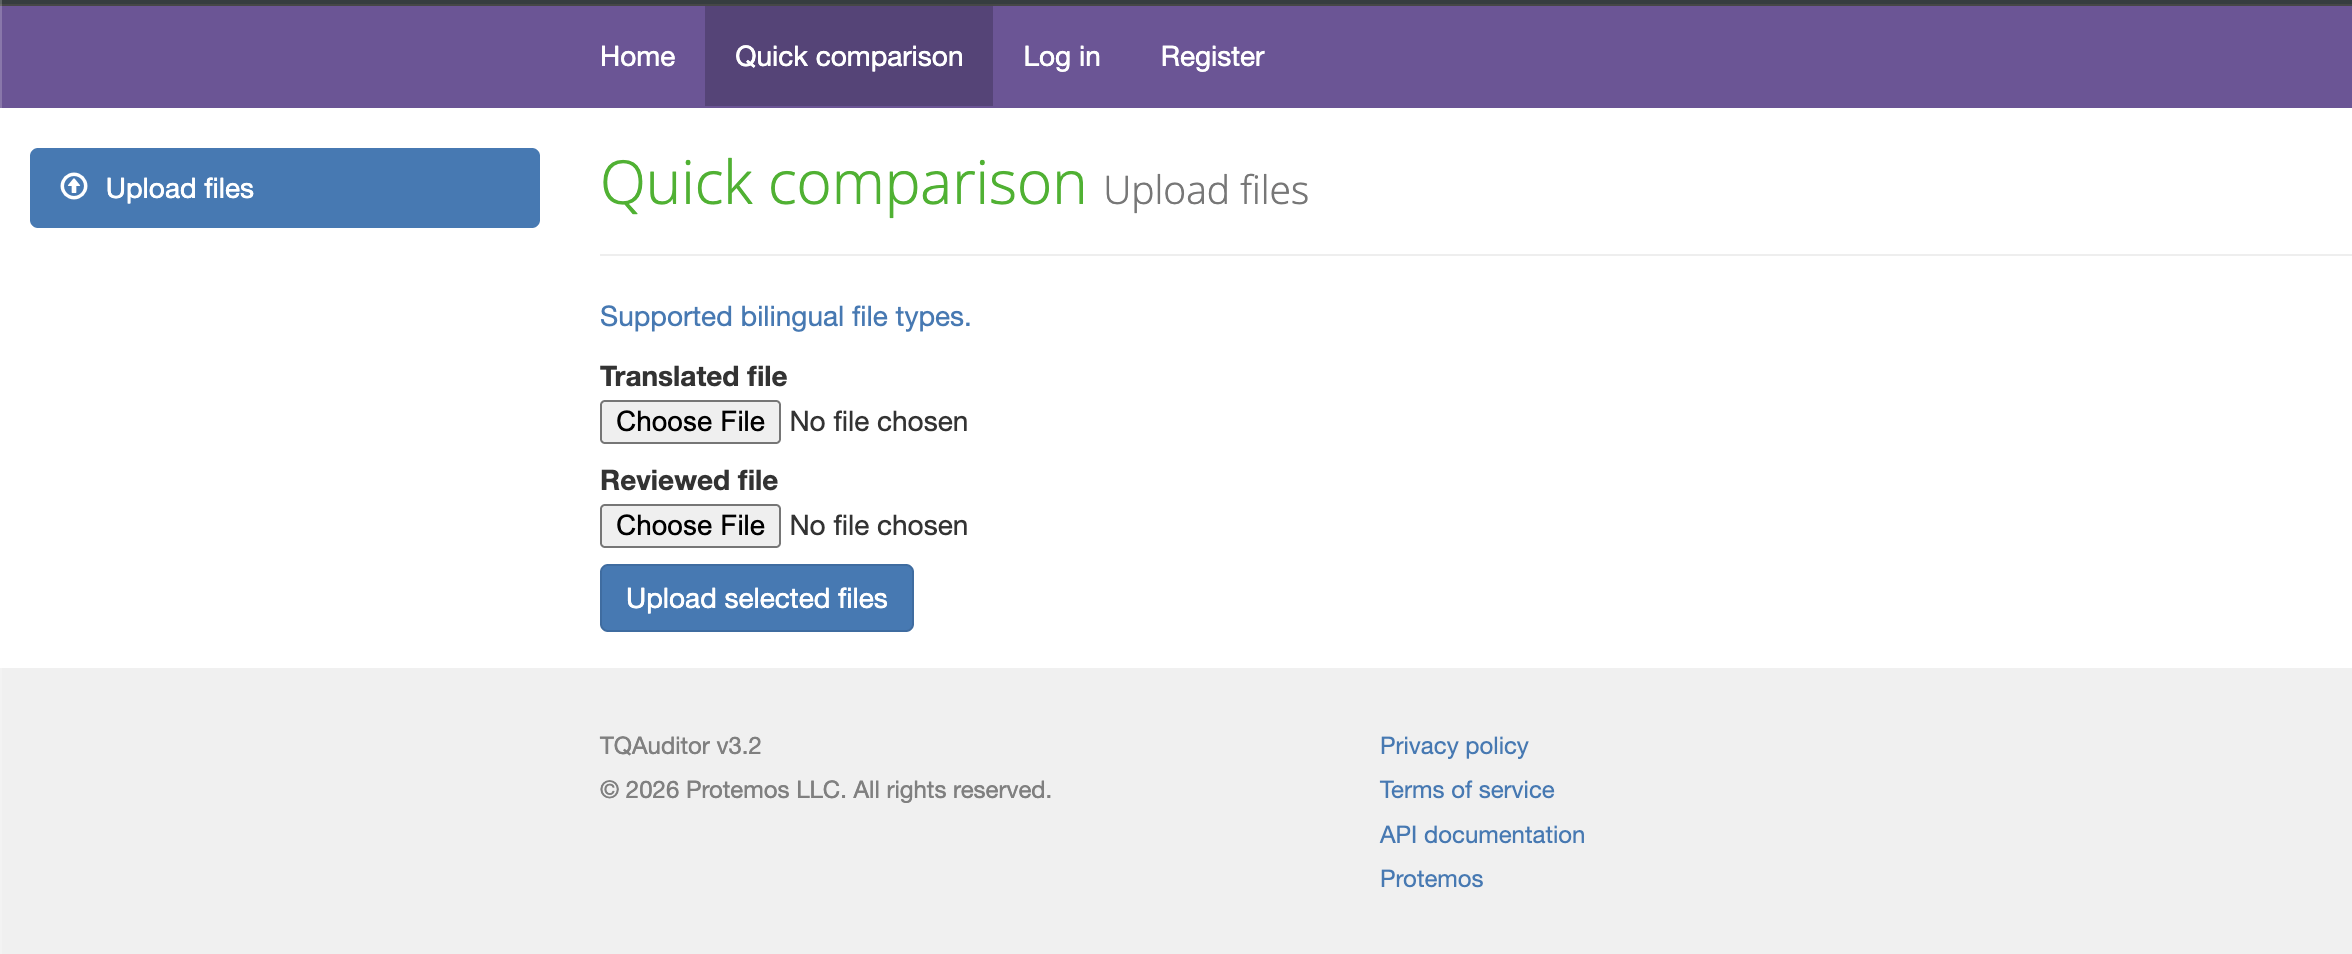
로컬라이제이션 프로젝트에서는 번역이 완료된 후 리뷰어가 다양한 수정 사항을 남긴다. 하지만 수정 내용이 많을수록 무엇이 어떻게 변경되었는지 확인하기가 쉽지 않다. 이럴 때 유용한 도구가 TQAuditor(TQAuditor Quick Comparison).

QAEditor는 번역본과 리뷰 완료본을 비교하여 수정된 내용을 자동으로 추적해 주는 웹 기반 비교 도구로, 별도의 회원가입 없이도 사용할 수 있으며, SDLXLIFF, XLIFF, TTX, TMX 등 다양한 이중언어(bilingual) 파일 형식을 지원한다. 

주요 기능

  • 번역본과 리뷰본의 변경 사항 자동 비교
  • 수정된 세그먼트 하이라이트
  • 태그(Tag) 변경 여부 확인
  • 수정된 세그먼트만 필터링
  • 비교 결과를 Excel로 내보내기
  • 회원가입 없이 빠른 비교 가능

사용 방법

  1. Translated file에 원본 번역 파일을 업로드
  2. Reviewed file에 리뷰가 완료된 파일을 업로드
  3. Upload selected files를 클릭
  4. 생성된 Comparison Report에서 변경 사항을 확인

활용법

QAEditor는 특히 다음과 같은 상황에서 유용하다.

  • 리뷰어의 수정 패턴을 분석하고 싶을 때
  • 번역 품질 교육 자료를 만들 때
  • 번역가에게 피드백을 제공할 때
  • 수정량(Change Rate)을 빠르게 확인하고 싶을 때
  • LQA(Quality Evaluation)를 시작하기 전에 변경 사항을 먼저 검토하고 싶을 때


학부생 시절, 나는 전공이 통번역이었음에도 (아니 어쩌면 전공이 통번역이었기 때문에) 그 기술이 구현되는 업계에 대해서는 무지했다. 번역이란 그저 한 사람의 고독한 번역가가 머리를 뜯으며 작업을 하는 것이 전부인 줄 알았고 그 멋에 푹 빠져 있었기에 Localization (또는 L10N) 업계에 대해 알아볼 생각조차 하지 않았을 수도 있지만. 그러나 이후에 프리랜서로 번역도 해보고 본격적으로 업계에 발을 들이면서 L10N에 관한 더 많은 인사이트를 얻고자 찾아보아도 그렇게 많은 리소스가 존재하지는 않았던 것이 사실이다. 


아래에 소개할 매거진과 팟캐스트는 적어도 내가 지난 몇 년 접한 바로는 업계 입문자나 단순히 L10N에 관심이 있는 사람도 큰 부담 없이 즐길 수 있는 몇 없는 리소스이다. 그나마 팟캐스트 The Loc Show는 에피소드가 10개 남짓한 신생 프로그램이다.ㅋ


물론 넓은 범위에서 번역/통역, 로컬라이제이션을 다루는 매거진이나 아티클은 여럿 존재하지만, 이 업계의 소식과 인사이트만을 다루는 매거진은 극히 드물고 그중에서 만듦새까지 괜찮은 리소스는 더욱 드물다. 그런 의미에서 MultiLingual의 가치는 더욱 빛난다. 격월로 발행되는 매거진은 발행 간격이 조금 길다는 점, 최근에는 디지털 에디션만 발행된다는 점 등이 아쉬워도 L10N에 종사하거나 관심이 있다면 아쉬운 소리를 할 수 없는(?) 귀한 리소스이다. multilingual.com의 홈페이지로 접속하면 매거진은 물론 각종 업계 관련 소식이나 이벤트 등도 확인할 수 있고 전 세계의 언어 서비스 제공업체들도 둘러볼 수 있다.


multilingual.com home
Multilingual Digital Archives


https://multilingual.com/


함께 소개할 팟캐스트 프로그램은 불과 두 달 전쯤 서비스를 시작한 따끈따끈한 프로그램인데, Smartling이라고 하는 온라인/클라우드 기반 번역 툴 및 언어 서비스 제공업체에서 론칭했다. 바로 위에서 소개한 Multilingual 매거진 최신호에서 광고를 보고 다운로드한 감상평은, 내가 접했던 로컬라이제이션 업계를 소개하는 콘텐츠 중 가장 유익하고 재미있다는 것이다. 혹여 내가 모르는 다른 콘텐츠가 이미 존재하는데 게으른 탓에 찾지 못한 것일 수도 있지만, 어쨌든... 주로 이 업계에 종사하는 다양한 분야의 전문가들을 초대해 대담을 나누며 로컬라이제이션 과정, 마주하는 어려움과 해결책, 성공 사례 등등을 공유하는데 무엇보다 재미가 있다! 이 업계에 대한 관심이 조금이라도 있는 사람이라면 강추하고 싶은 팟캐스트이다.


The Loc Show by Smartling


https://www.smartling.com/podcasts/locshow/?utm_source=Paid+-+Digital+Advertising&utm_medium=MultiLingual&utm_term=The+Loc+Show&utm_content=The+Loc+Show&utm_campaign=2020+Q2+All%3A+The+Loc+Show


'번역본의 품질이 좋다'라고 할 때, 여러 가지 기준과 조건들이 있을 것이다. 번역문인지 알 수 없을 정도로 맛깔난 문체일 수도 있고, 원문의 의미를 빠짐없이 전달하는 정확한 번역일 수도 있다. 그러나 그런 것들에 종종 가려질지언정 그보다 더 중요할 수 있는 조건도 있다. 기본적인 맞춤법/문법 오류의 유무이다. 물론 그야말로 기본 중의 기본인 맞춤법/문법이 정확하다고 해서 번역본의 품질이 좋다는 보장은 할 수 없다. 그러나 좋은 번역은 반드시 그 기본을 바탕으로 출발한다. 문제는 그 중요한 맞춤법/문법 검사를 어떻게 할 것인가,이다.

여기에 소개하는 한국어 맞춤법/문법 검사기는 부산대 인공지능 연구실과 나라인포테크가 만든 맞춤법 검사기로, 우리나라에서 쓸 수 있는 맞춤법/문법 검사기로는 가장 쓸 만한 무료 도구이다. 

http://speller.cs.pusan.ac.kr/


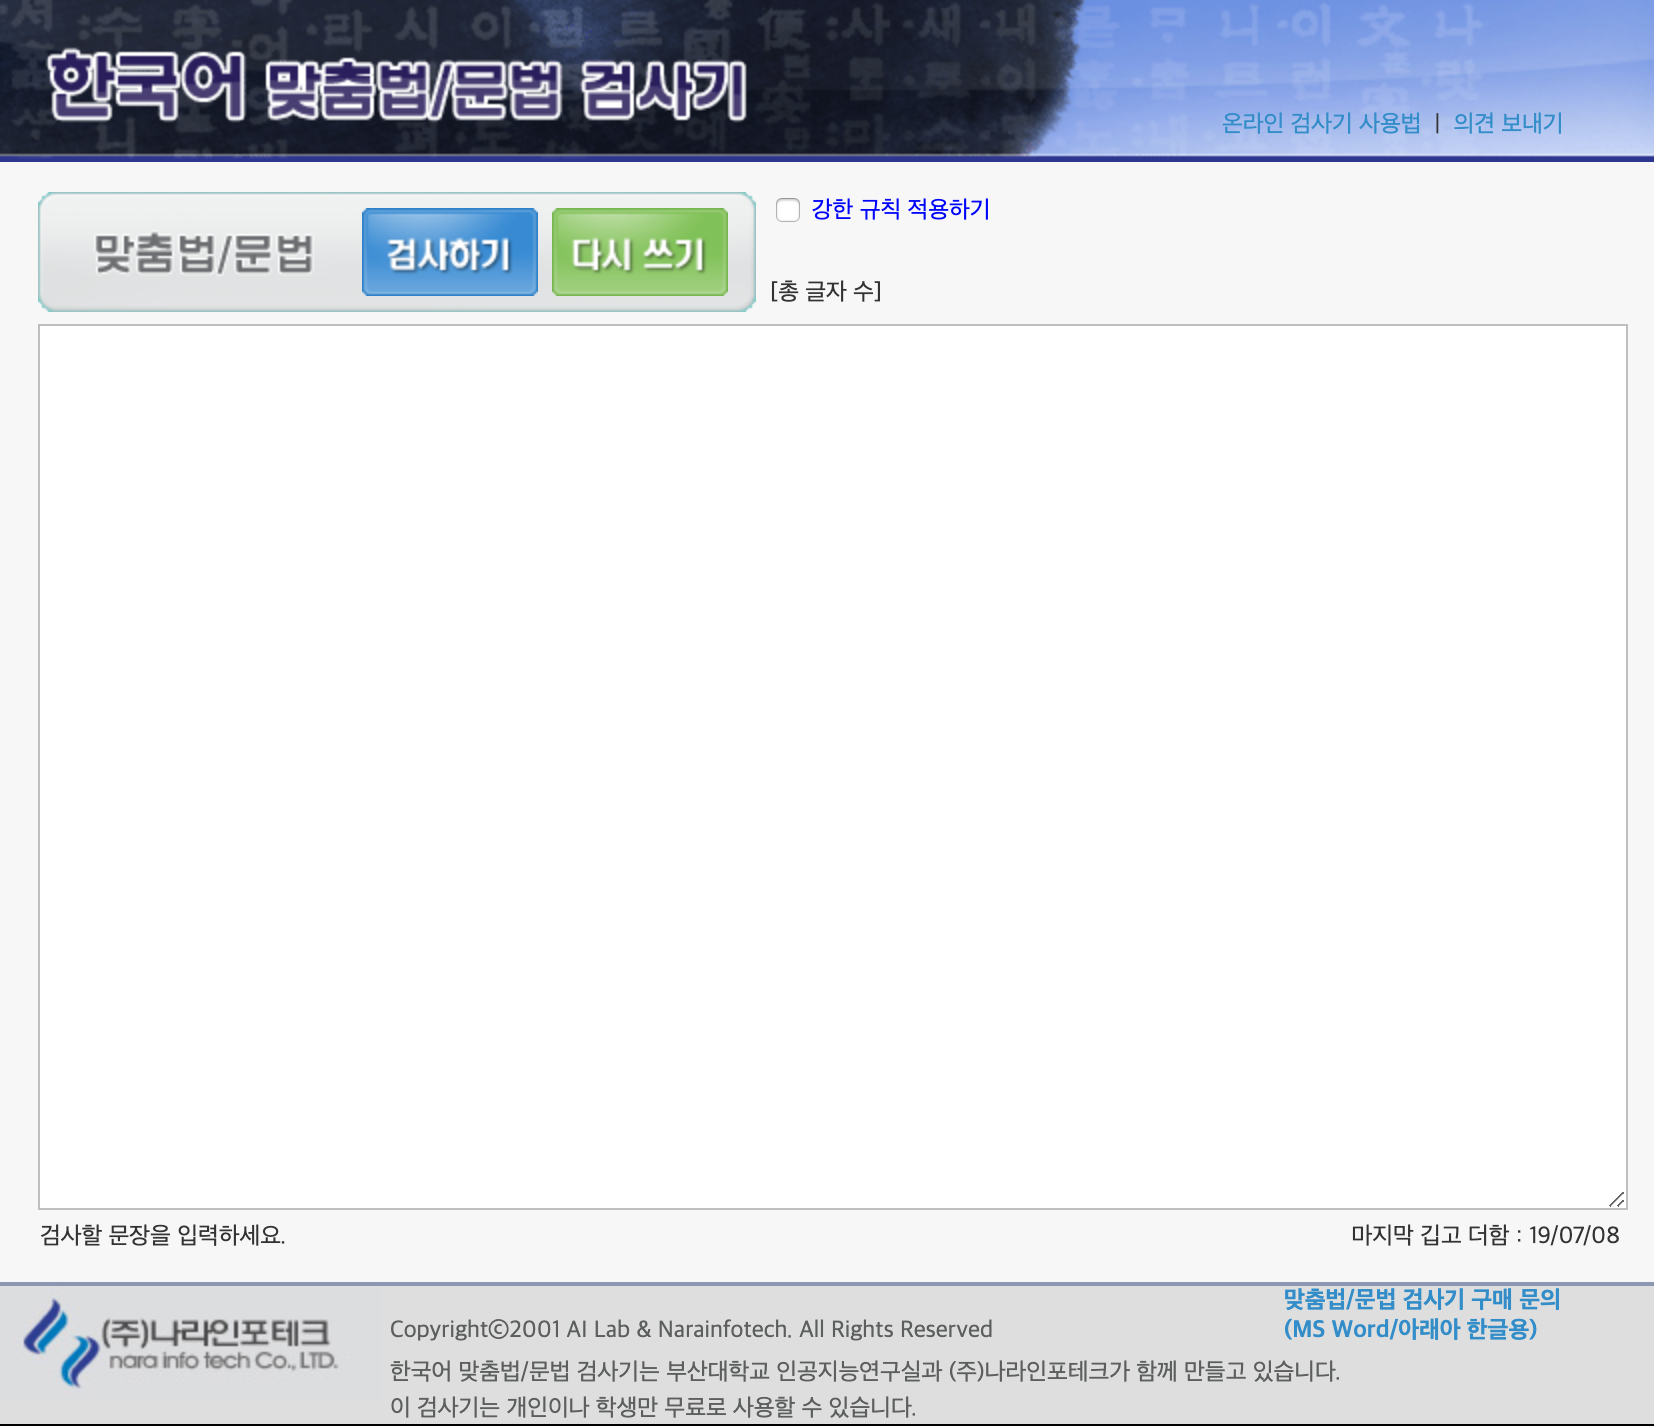
한국어 맞춤법/문법 검사기

Copyrightⓒ2001 AI Lab & Narainfotech. All Rights Reserved 한국어 맞춤법/문법 검사기는 부산대학교 인공지능연구실과 (주)나라인포테크가 함께 만들고 있습니다. 이 검사기는 개인이나 학생만 무료로 사용�

speller.cs.pusan.ac.kr

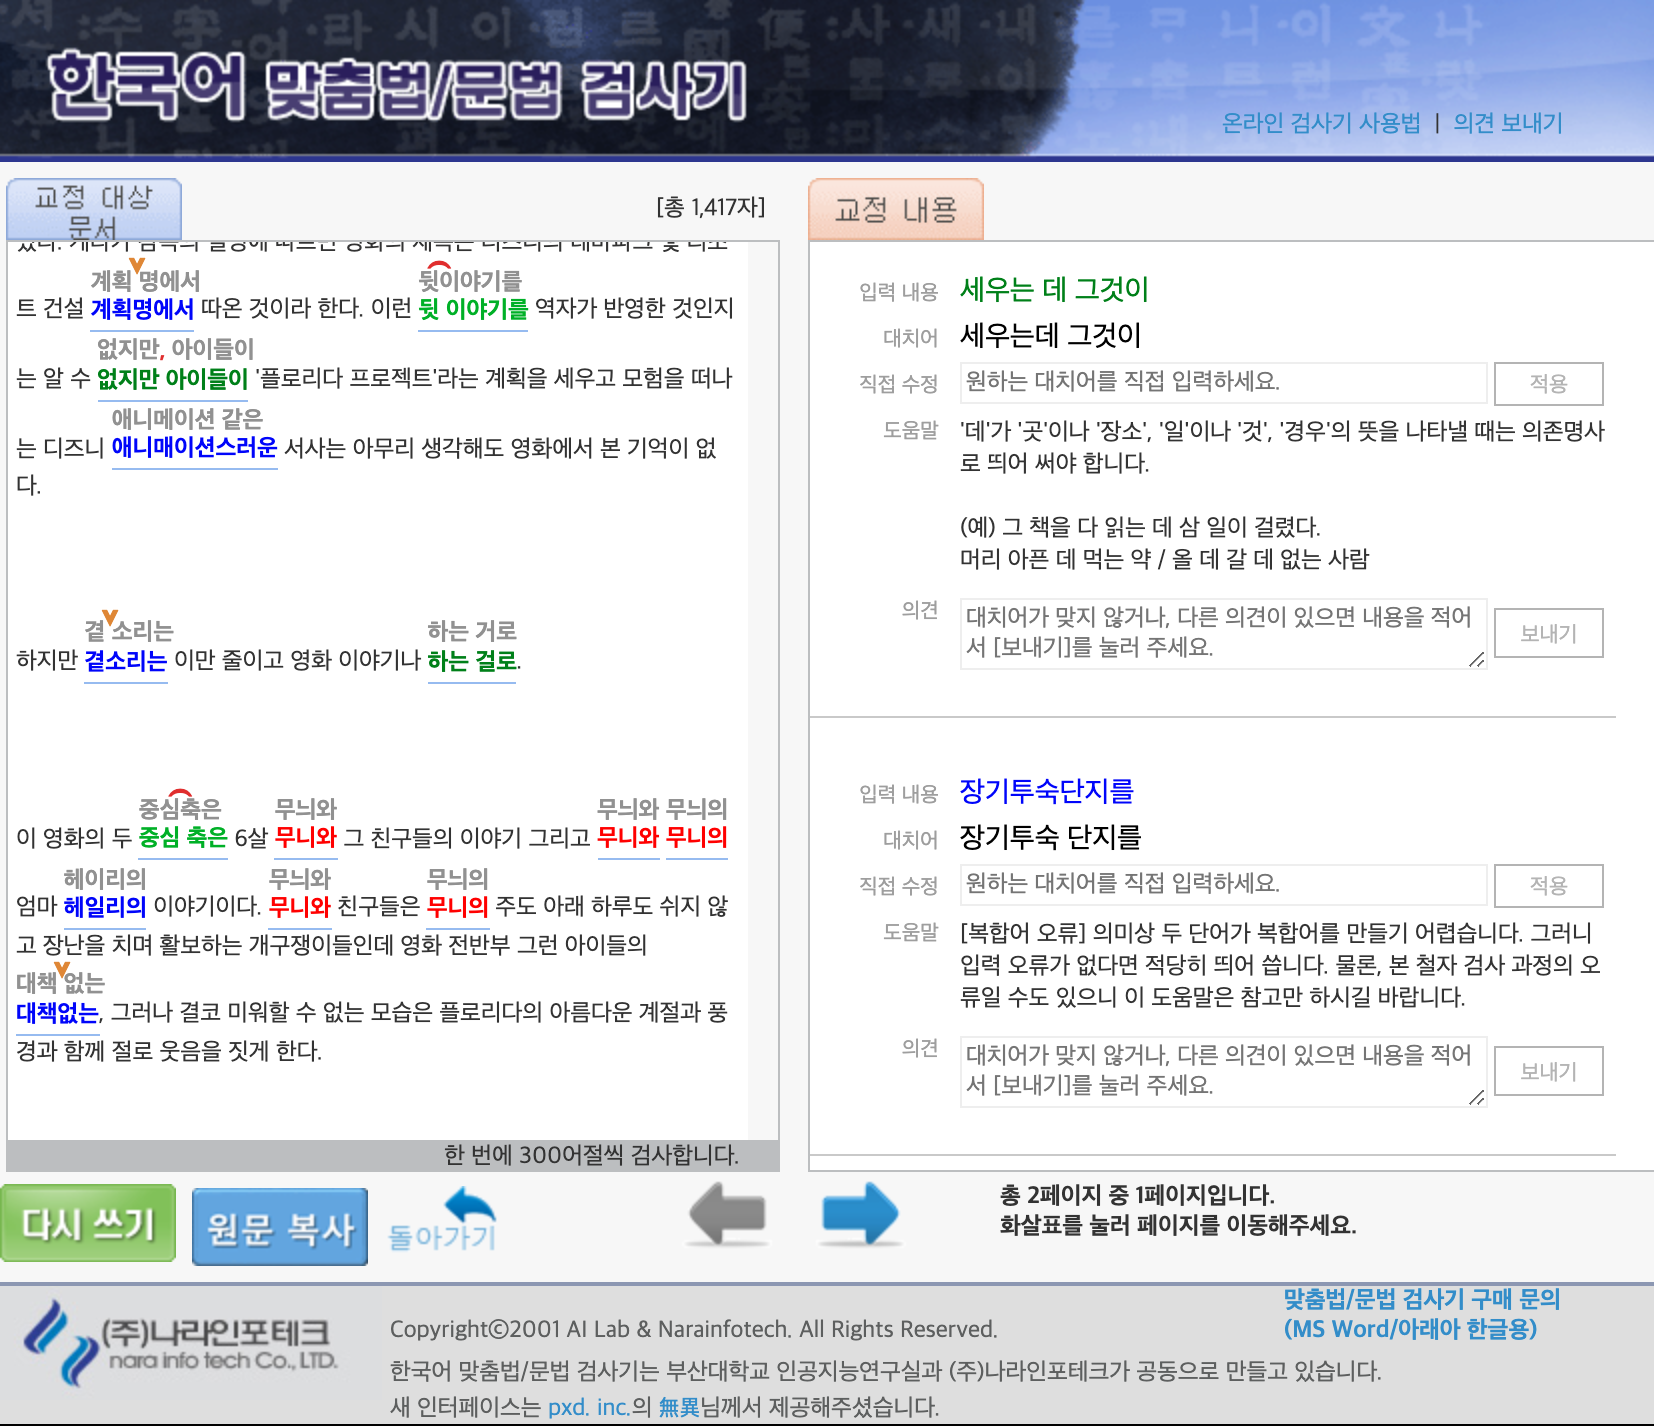
위의 주소를 들어가면 아래 스크린샷처럼 참으로 직관적인 디자인의 페이지를 만날 수 있는데, 영문 문법/맞춤법 검사기의 대표 주자인 Grammarly에 비하면 투박해보이는 것도 사실이다. 그러나 비교만큼 자식 교육에 해로운 것도 없다는데, 굳이 남의 자식(?)과 비교하지 않아도 한국어 맞춤법 검사기 또한 충분히 좋은 도구이다.


사용 방법은 간단하다. 텍스트를 복사 붙여넣기 한 다음 검사하면 끝. 상단에 '강한 규칙 적용하기'라는 옵션도 친절하게 마련되어 있는데, 사실 쓸 일은 많지 않다. 무한정 길이의 텍스트를 한 번에 검사할 수 있는 것은 아니고, 한 번에 대략 10,000자 이상 넘어가면 오류가 발생하는 것 같다. 조금은 아쉬운 점 중에 하나인데, 볼륨이 큰 번역 작업 후 검사 시에는 텍스트를 여러 차례 나눠서 검사해야 하는 번거로움이 있다. 물론, 유료로 구입 가능한 Word/한글용 검사기를 사면 문제 해결.


블로그에 올렸던 '플로리다 프로젝트' 영화 리뷰를 맞춤법 검사기에 돌려보니..?


그렇게 검사기에 텍스트를 넣고 돌려보면 위와 같이 결과가 나오는데, 당연히 완벽함을 기대할 수는 없다. 누군가 말했듯 언어는 살아 움직이는 생명체 같아서 무수한 변수가 존재하고 매일 그 변수가 변하는데 그 속도를 맞춤법 검사기가 따라잡기란 불가능한 노릇. 그러나 기본적인 맞춤법/문법 검사기로서의 역할은 넉넉하게 수행한다.  

+ Recent posts