번역 품질 측정 모델 MQM(Multidimensional Quality Metrics)
번역 품질을 평가할 때 단순히 “좋다” 또는 “나쁘다”라고 판단하는 것만으로는 충분하지 않다. 특히 여러 언어와 벤더를 동시에 관리하는 로컬라이제이션 환경에서는 품질을 일관된 기준으로 분류하고 측정할 수 있는 방법이 필요하다. 이때 가장 대표적으로 사용되는 프레임워크 중 하나가 MQM(Multidimensional Quality Metrics)이다.
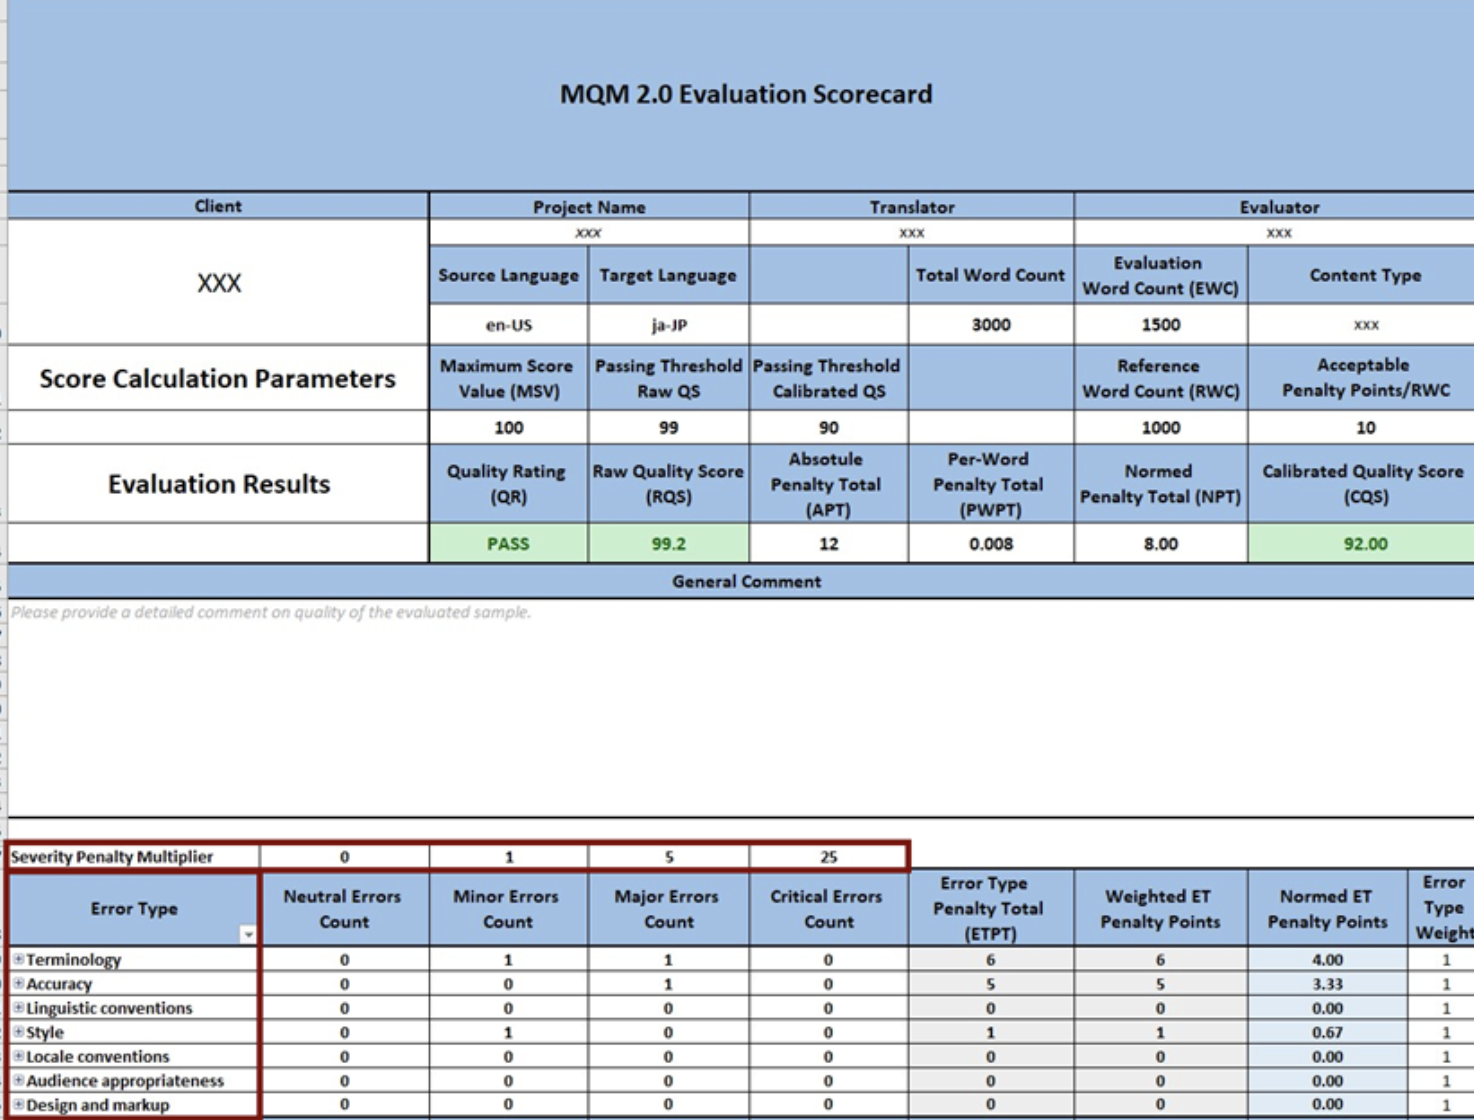
MQM은 번역에서 발견되는 문제를 오류 유형(Error Type)과 오류 심각도(Severity)에 따라 분류하는 품질 평가 프레임워크다.
예를 들어 아래와 같은 번역이 있다면 문법적으로는 자연스럽지만 의미가 잘못 전달되었으므로 Accuracy → Mistranslation 오류로 분류할 수 있다.
Source: Delete account
Translation: 계정에서 로그아웃
반면, "계정을 삭제 할 수 있습니다."처럼 의미 전달에는 문제가 없지만 띄어쓰기가 잘못되었다면 Fluency 계열의 오류로 볼 수 있다. 즉, MQM은 모든 문제를 단순히 ‘오류 1건’으로 계산하는 것이 아니라 무엇이 잘못되었는지, 그리고 그 오류가 얼마나 중요한지를 구분한다.
MQM 대표 오류 유형
MQM은 계층적인 오류 분류법을 제공한다. 실제로는 프로젝트와 콘텐츠에 따라 필요한 항목을 선택하거나 세분화해서 사용할 수 있다.
| 유형 | 평가 대상 | 대표 세부 오류 |
| Accuracy | 원문의 의미가 정확하게 전달되었는가 | Mistranslation, Omission, Addition |
| Terminology | 적절하고 일관된 용어를 사용했는가 | Wrong Term, Inconsistent Term |
| Fluency | 번역문 자체가 언어적으로 올바른가 | Grammar, Spelling, Punctuation |
| Style | 요구되는 문체와 스타일을 따르는가 | Register, Style Guide 위배 |
| Locale Convention | 해당 지역의 표기 관습을 따르는가 | 날짜, 시간, 숫자, 통화, 단위 |
| Design & Markup | 형식이나 구조에 문제가 없는가 | Tag, Markup, Layout 문제 |
물론 모든 카테고리를 사용할 필요는 없다. 일반적인 소프트웨어 로컬라이제이션이라면 Accuracy, Terminology, Fluency, Style, Locale Convention 정도의 핵심 카테고리로 시작하고 필요에 따라 세분화하는 것도 흔하다.
오류의 심각도
같은 종류의 오류라도 사용자에게 미치는 영향은 다르다. 따라서 MQM에서는 오류 유형과 함께 심각도를 기록한다.
| 심각도 | 의미 | 예시 |
| Minor | 이해나 사용에 큰 영향을 주지 않는 오류 | 사소한 문법, 철자, 구두점 오류 |
| Major | 의미 전달이나 사용성에 상당한 영향을 주는 오류 | 중요한 오역, 잘못된 제품 용어 |
| Critical | 안전·법률·재정·데이터 등에 심각한 영향을 줄 수 있는 오류 | 안전 경고의 의미 반전, 법적 정보 오역 |
여기서 중요한 것은 오류의 양과 심각도가 반드시 비례하지 않는다는 점이다. 단어 하나가 잘못 번역되었더라도 사용자의 안전이나 데이터에 영향을 준다면 Critical 오류가 될 수 있다.
MQM 점수 계산
Severity에 가중치를 부여하면 번역 품질을 정량화할 수도 있다. 예를 들어 우리 팀에서 다음과 같이 가중치를 정했다고 가정해보자.
| 심각도 | 가중치 |
| Minor | 1 |
| Major | 5 |
| Critical | 25 |
1,000단어를 리뷰해서 Minor 3건, Major 2건이 발견되었다면 다음과 같이 페널티가 발생한다.
(3 × 1) + (2 × 5) = 13
이를 전체 단어 수로 정규화해 '1,000단어당 오류 점수'와 같은 내부 품질 지표를 만들 수도 있다. 다만 MQM이 특정한 가중치나 하나의 절대적인 Pass/Fail 점수를 강제하는 것은 아니다. 조직은 콘텐츠의 특성과 품질 목표에 맞게 점수 산정 모델과 Pass/Fail 기준을 설계할 수 있다.
MQM의 활용
MQM 데이터가 축적되면 단순한 번역 검수를 넘어 다양한 품질 분석이 가능하다.
| 언어별 품질 추적 | 한국어와 일본어의 분기별 Quality Score 비교 |
| Vendor Performance | 벤더별 Accuracy/Major 오류율 비교 |
| Error Trend 분석 | Terminology 오류가 지속적으로 증가하는지 확인 |
| Root Cause Analysis | 반복되는 오류가 번역, 용어집, 소스, 컨텍스트 중 어디에서 발생하는지 분석 |
| MT/AI 평가 | Human Translation, MT, LLM 번역의 오류 유형 비교 |
특히 MQM의 장점은 “품질이 낮다”에서 끝나지 않고 왜 품질이 낮은지를 데이터로 볼 수 있다는 것이다. Terminology 오류가 반복된다면 텀베이스를 개선할 수 있고, 여러 언어에서 동일한 Accuracy 오류가 발생한다면 번역가보다 원문 자체나 맥락 제공 방식에 문제가 있을 가능성도 살펴볼 수 있다.
MQM의 장점과 단점
| 장점 | 단점 |
| 품질을 구조적으로 측정할 수 있다 | 리뷰에 시간과 비용이 든다 |
| 오류의 원인을 구체적으로 분석할 수 있다 | 리뷰어마다 판단 기준이 달라질 수 있다 |
| 언어·벤더·기간별 비교가 가능하다 | 지나치게 복잡한 세부 분류법은 운영하기 어렵다 |
| 프로젝트에 맞게 커스텀할 수 있다 | 점수가 번역의 모든 측면을 설명하지는 못한다 |
| MT/AI 번역 평가에도 활용할 수 있다 | 리뷰어 트레이닝과 정렬 작업이 필요하다 |
MQM 활용 시 가장 중요한 것
MQM을 도입한다고 해서 번역 품질이 자동으로 객관화되는 것은 아니다. 예를 들어 동일한 오류를 한 리뷰어는 Major라고 판단하고 다른 리뷰어는 Minor라고 판단한다면 두 사람이 만든 MQM 점수를 그대로 비교하기 어렵다.
특히 여러 언어를 평가할 때는
한국어 Quality Score: 82
일본어 Quality Score: 95
라는 결과가 실제 품질 차이인지, 아니면 한국어 리뷰어가 일본어 리뷰어보다 엄격하기 때문인지 구분하기 어려울 수 있다. 따라서 MQM을 안정적으로 운영하려면 명확한 오류의 정의와 심각도 기준, 실제 예시, Reviewer Training, 그리고 정기적인 리뷰어 평가 기준 정렬 작업(Reviewer Calibration)이 함께 필요하다.
리소스
MQM을 실제 품질 평가에 적용해보고 싶거나 더 자세하게 알아보고 싶다면 MQM Council 웹사이트를 참고해보길 추천하다. 오류 유형과 심각도를 실제 점수로 변환하는 방법부터 가중치, Pass/Fail 기준을 설정하는 방법까지 자세히 설명되어 있으며, 바로 활용해볼 수 있는 Excel 기반 MQM Scorecard도 무료로 제공한다. 처음부터 자체 평가표를 만드는 것보다 이 자료를 바탕으로 조직이나 프로젝트에 필요한 Error Type과 평가 기준을 조정해 보는 것도 좋은 출발점이 될 수 있다.